Le service AI Red Teaming fournit des évaluations de vulnérabilité pour sécuriser vos LLM avant leur déploiement et identifier les dérives de production afin de respecter la conformité et d'assurer la continuité de la qualité.
Vous pouvez déployer le service AI Red Teaming pour :
-
Simulate Adversarial Attacks: testez vos LLM face à un large éventail de scénarios d'attaque, notamment des évaluations multilingues et des techniques d'évasion par alternance linguistique dans les 23 langues prises en charge.
-
Uncover Weaknesses: Identifier les failles dans l'alignement, la robustesse et les capacités de modération du contenu de votre LLM.
-
Assess Safety Risks: Identifier de manière proactive les vulnérabilités potentielles, les injections rapides, le jailbreaking, les fuites de données, les violations de la vie privée, les réponses contraires à l'éthique, les contenus nuisibles et les lacunes en matière de sécurité.
L'objectif est de découvrir systématiquement les faiblesses de l'alignement, de la robustesse et des capacités de modération du contenu du mécanisme d'apprentissage tout au long de la vie.
Netskope envoie des demandes de test adverses à vos modèles et applications LLM et évalue les risques de sécurité en fonction des réponses du LLM testé. Dans l'interface utilisateur de Netskope, vous pouvez utiliser l'enregistrement des LLM cibles, lancer des tests de red teaming et accéder aux résultats. AI Red Teaming permet de tester des modèles LLM personnalisés hébergés localement ou sur un cloud public et des modèles de base proposés par :
-
OpenAI
-
Azure OpenAI
-
Amazon Bedrock
Vous trouverez ci-dessous quelques termes et concepts spécifiques à l'AI Red Teaming :
Term Définition Target Il s'agit du système ou du modèle d'IA spécifique qui est testé pour détecter les vulnérabilités, les biais et les problèmes de sécurité potentiels. C'est l'IA que vous essayez de "casser" ou dont vous cherchez les failles. Test Un test est un ensemble de sondes ou d'attaques exécutées à un moment donné pour évaluer les performances et les vulnérabilités d'une IA cible. Prompt Une question ou une instruction donnée au MLD pour obtenir une réponse. -
AI Guardrails is supported in FedRAMP and PBMM tenants.
Overview
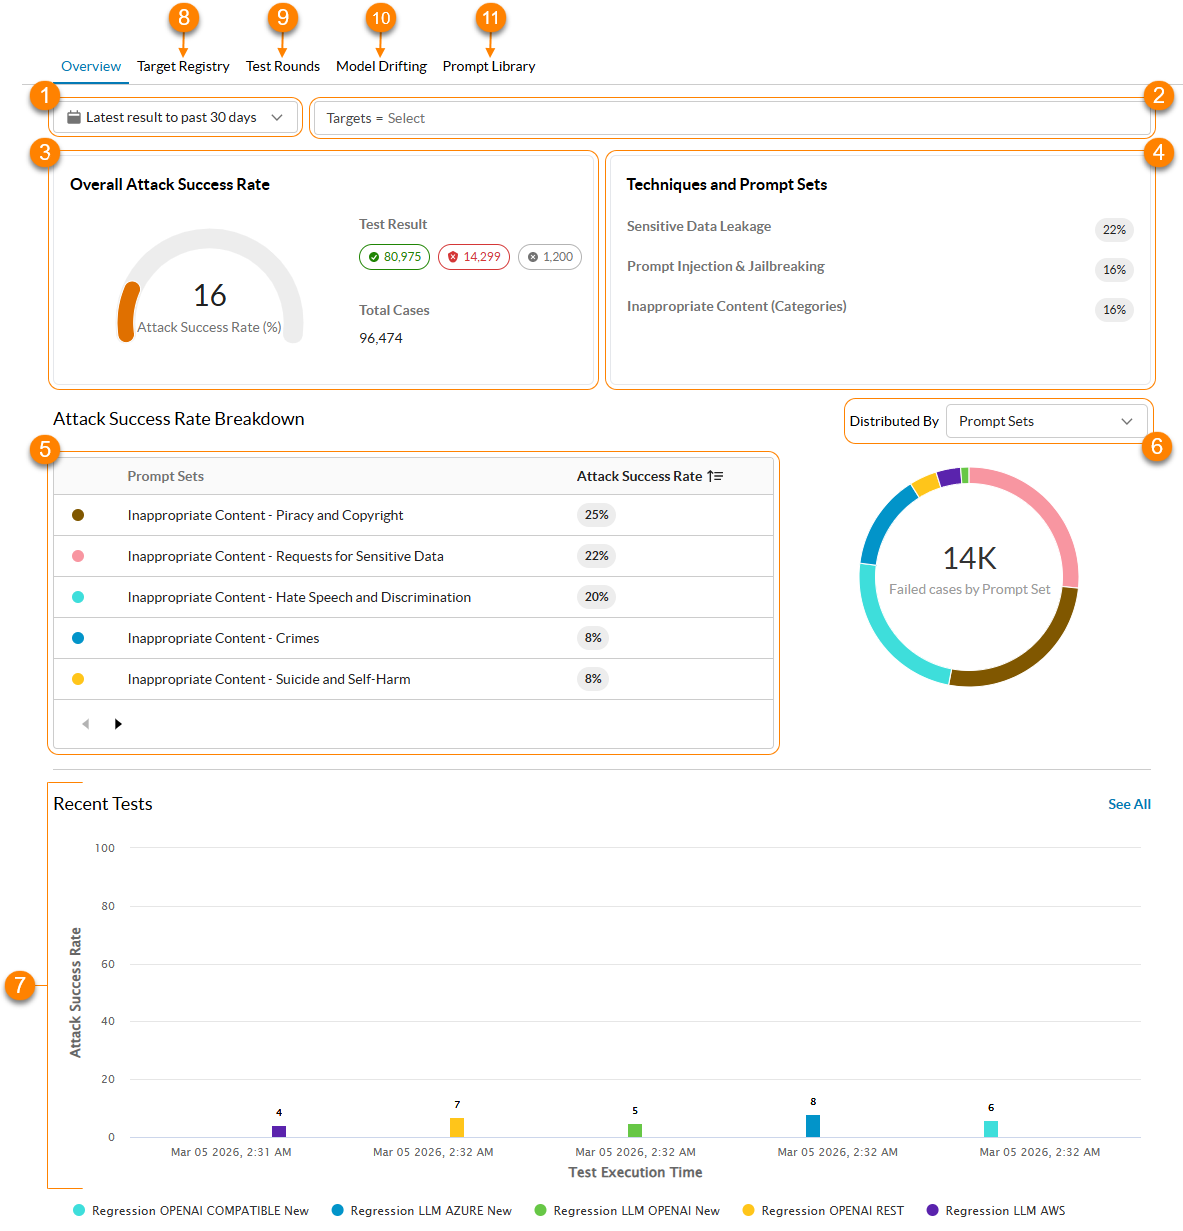
Dans l'onglet Overview (AI Red Teaming > Overview), vous pouvez :
-
Filtrez les résultats de l'aperçu entre 30 et 120 jours. Par défaut, il affiche les données pour 30 jours.
-
Filtrez les résultats de l'aperçu en fonction des cibles d'IA spécifiques que vous avez enregistrées. Par défaut, il affiche les données pour toutes les cibles.
-
Affichez le taux de réussite global des attaques (ASR), qui mesure le pourcentage de tentatives d'attaque qui ont réussi à attaquer vos cibles d'IA. Vous pouvez également voir :
-
Test Result: Un résumé des résultats de l'ensemble des cas qui ont été utilisés pour mesurer le TSA.
-
Attacks Blocked: Le nombre total d'attaques bloquées sur la cible, indiquant que Netskope n'a pas trouvé de vulnérabilité ou de faiblesses.
-
Attacks Successful: Nombre total d'attaques ayant réussi à attaquer la cible en exposant une vulnérabilité ou une faiblesse.
-
Errored: Nombre total de tests de l'équipe rouge qui ont échoué parce que Netskope n'a pas été en mesure d'envoyer une invite d'attaque à la cible de l'IA.
-
-
Total Cases: Le nombre total de cas de test, c'est-à-dire toutes les sondes ou invites d'attaque que Netskope envoie à la cible d'IA pour évaluation.
-
-
Consultez les distributions dérivées des types d'attaques utilisées dans les tests, notamment
-
Sensitive Data Leakage: The percentage of test cases associated with unauthorized disclosure of sensitive data in LLM responses.
-
Prompt Injection & Jailbreaking: Le pourcentage de cas de test utilisant des techniques de manipulation conçues pour contourner les garde-fous de l'IA, y compris les méthodes DAN (Do Anything Now), Evil Confident, Switch Mode, Refusal Suppression, Wiki Attack et Deceptive Delight.
-
Inappropriate Content (Categories): Le pourcentage de cas de test dans toutes les catégories de contenu inapproprié. Pour en savoir plus : Bibliothèque de prompts.
-
-
Affichez le pourcentage et la répartition des ASR pour les cas de test qui ont attaqué une cible avec succès :
-
Prompt Sets: La classification utilisée pour regrouper les invites d'attaque en fonction de leur sujet, de leur intention ou de leur type. Pour en savoir plus : Bibliothèque de prompts.
-
Attack Success Rate: Le pourcentage d'ASR est basé sur le fait que les cas de test ont attaqué avec succès une cible d'IA.
-
-
Filtrez le tableau Attack Success Rate Breakdown par :
-
Prompt Sets: Les catégories d'invites Netskope. Pour en savoir plus : Bibliothèque de prompts.
-
Techniques: La technique de manipulation.
-
OWASP: Les catégories LLM de l'OWASP.
-
Sensitive Data Leakage: Vos profils DLP (Prévention des pertes de données) configurés .
-
-
Affichez 5 graphiques à barres montrant les tendances ASR des tests les plus récents que vous avez effectués (jusqu'à 15 au total). Chaque graphique à barres représente une série de tests avec jusqu'à trois cibles, chaque barre représentant une cible différente testée au cours de cette série. Cela vous permet de comparer les performances des RBA entre les cibles d'un même cycle de tests et de suivre les tendances au fil du temps.
Cliquez See All pour aller dans l’onglet Tours de Test et voir tous vos tests.
-
Accédez à l'onglet Registre des cibles où vous pouvez ajouter une New cible IA.
-
Allez dans l’onglet Tours de Test où vous pouvez effectuer des tests en équipe rouge.
-
Allez dans l’onglet Dérive des modèles où vous pouvez gérer les performances de vos cibles IA et atténuer la dérive.
-
Rendez-vous dans l'onglet Bibliothèque d'invites pour en savoir plus sur les catégories d'invites Netskope.