

Dans Netskope DLP (Prévention des pertes de données), Entities fait référence aux identificateurs de données et aux dictionnaires. Les identificateurs de données sont des termes communs utilisés pour catégoriser certains types de données identifiables, et les dictionnaires sont des fichiers contenant des mots-clés et des expressions régulières. Les entités sont utilisées dans une règle pour identifier les données sensibles.
Netskope propose également Predefined AI Entities, qui utilisent la reconnaissance d’entités nommées (NER) pour détecter des données non structurées et contextuelles, telles que des noms ou des identifiants génomiques, que la seule correspondance de motifs ne permet pas de détecter de manière fiable. Cela nécessite une licence supplémentaire. Pour plus de détails sur le fonctionnement des entités basées sur la NER et sur leur utilisation dans une règle, consultez Select Predefined Entities.
Pour ouvrir la page Entités, dans l'interface utilisateur de Netskope, allez sur Policies > Profiles > DLP > EDIT RULES et sélectionnez Data Loss Prevention. Cliquez ensuite sur l'onglet Entities.

Entités prédéfinies
Netskope fournit une large liste d’entités prédéfinies avec des noms et des descriptions significatifs. La liste complète des entités prédéfinies peut être consultée dans le workflow New DLP (Prévention des pertes de données) Rule.
Pour afficher la liste complète des entités prédéfinies, cliquez sur New Rule dans l’onglet Règles de la page Règles de prévention des pertes de données. Dans la boîte de dialogue permettant de créer une règle New DLP (Prévention des pertes de données), toutes les entités prédéfinies sont répertoriées par catégorie.

Vous pouvez également créer vos propres entités personnalisées.
Pour créer des entités personnalisées :
- Dans l'onglet ENTITÉS, cliquez sur NEW ENTITY. La boîte de dialogue Créer une entité s'affiche avec l'option Data identifier sélectionnée.
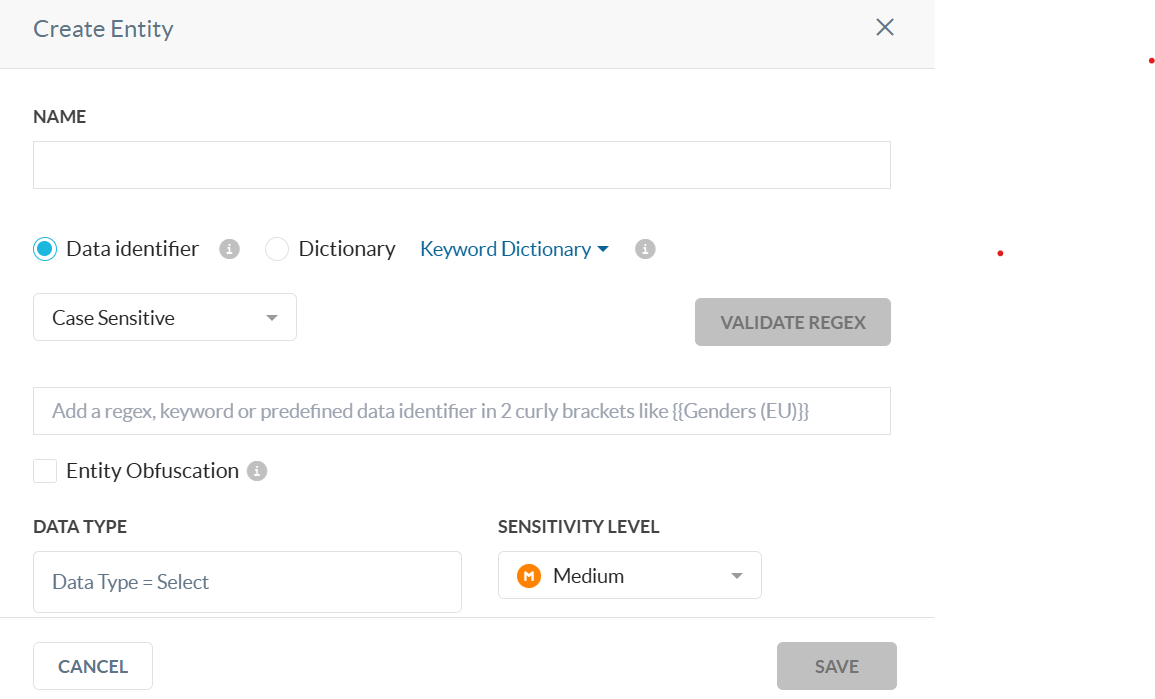
- Attribuez un nom à l'entité personnalisée et choisissez si la nouvelle entité est sensible à la casse ou non.
- Ajoutez une entité prédéfinie au format
{{predefined_data_identifier}}, un mot-clé ou une expression régulière. Par exemple, un identifiant prédéfini tel que{{Full Names (US)}}, un mot-clé tel queNameou une expression régulière telle que[0-9]{5,10}Cliquez sur le bouton Validate Regex pour valider la syntaxe de l'expression régulière. Pour plus d'informations sur les opérateurs, quantificateurs et métacaractères pris en charge pour les expressions régulières, voir Construction d'expressions régulières.
- Select un Data Type existant ou créez-en un New Data Type.
- Select un Sensitivity Level.
- Sous Options avancées, vous pouvez définir diverses conditions pour restreindre les résultats lorsque cette entité est utilisée dans une règle DLP (Prévention des pertes de données). Pour en savoir plus, consultez la section Options avancées.
Entity Redaction
Entity Redaction (anciennement Entity Obfuscation) est une capacité de désidentification des données qui expurge les informations sensibles détectées par les correspondances d’entités dans les profils DLP (Prévention des pertes de données).
By enabling Entity Redaction, this entity’s matched data will be obfuscated in DLP’s incident forensic data. On any obfuscation/masking method, if the number of masked characters in the match is fewer than 5, then all of the digits and/or letters are masked.
Deprecated:

Updated:

Incident Forensics: Forensic workflows will remain unchanged. The system continues to support incident records and dedicated forensic views without any modification.
Configuration Steps
- Pre-defined entities – Implicit Masking
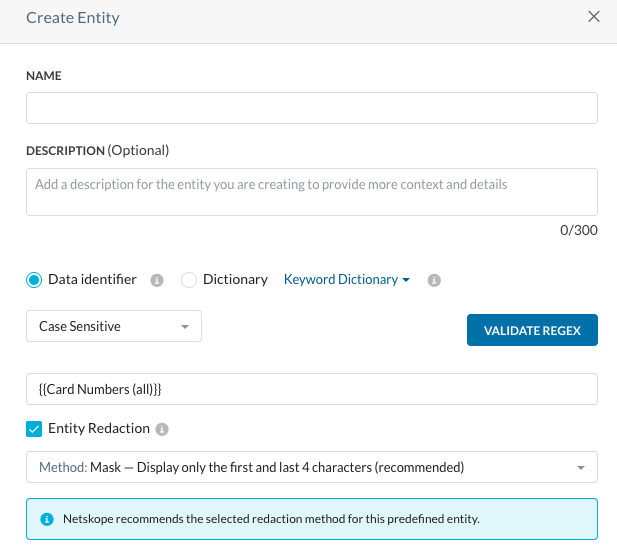
Lorsque vous clonez une entité prédéfinie, Netskope active automatiquement la réduction d’entités et sélectionne une méthode de masquage recommandée pour cette entité. L’exemple suivant montre la boîte de dialogue Créer une entité après avoir cloné l’entité Numéros de carte (tous). Le champ Méthode affiche Masque — Affiche seulement les 4 premiers et 4 derniers caractères (recommandé), et une bannière d’information confirme que Netskope recommande cette méthode pour l’entité prédéfinie.
- Custom entities – Adds Custom Masking capabilities

- Criminalistique des incidents
Nom : John Smith
XXX : XXX-XX-XXXX
Email : john.smith@example.com
Date de naissance : 15/03/1985
Filtres
Filters Rejetez les correspondances improbables ou peu plausibles. Il existe des considérations particulières pour les Entitiesprédéfinis.
Use Filters - propose deux filtres : "Common-Sense" et "Unlikely Matches".
- Si un site prédéfini Entity n'a pas de filtre, les options Use Filters et Use Validator for Regex sont grisées.
- Si un site prédéfini Entity ne possède qu'un seul des deux filtres, l'option Use Validator For Regex est grisée et le validateur par défaut de l'entité prédéfinie sélectionnée est appliqué.
- Si un site prédéfini Entity possède les deux filtres, le site Use Filters et les deux filtres situés en dessous seront vérifiés. Use Validator for Regex seront grisées.
Netskope integrates text normalization, addressing elements like fonts, colors, line folding, and spacing into the text extraction process across certain schemas. Beyond enhancing detection accuracy, this normalization may serve as a functional countermeasure against text-based steganography.
Dictionary
Un dictionnaire peut être un dictionnaire de mots-clés ou un dictionnaire d'expressions régulières. Un fichier dictionnaire est un fichier CSV qui peut contenir des mots-clés et des phrases, ou des expressions régulières que vous souhaitez trouver à l'aide d'une règle DLP (Prévention des pertes de données). Chaque fichier de dictionnaire peut contenir soit des mots-clés et des phrases, soit des expressions régulières.
Pour utiliser un fichier de dictionnaire, créez un fichier CSV avec un mot-clé, une expression ou une expression régulière par ligne. Un fichier de dictionnaire d'expressions régulières peut contenir jusqu'à 25 entrées. Pour plus d'informations sur les opérateurs, quantificateurs et métacaractères pris en charge pour les expressions régulières, consultez la section Création d'expressions régulières.
Netskope prend également en charge les dictionnaires pondérés dans lesquels vous pouvez spécifier un poids pour chaque mot-clé ou phrase. Le poids d'un mot-clé est le nombre sur lequel le score de violation est calculé. Le score de violation d'une règle est la somme des poids du nombre de règles, le nombre de règles étant le nombre de fois qu'une règle est appliquée. Plus le poids du mot-clé est élevé, plus le score de violation est important. Le score de violation détermine quand déclencher une règle en cas de violation. Si aucune pondération n'est spécifiée, une pondération par défaut de 1 est attribuée au mot-clé ou à l'expression.
Note
Aucun poids n'est attribué aux expressions régulières.
Pour définir le mot-clé dans le fichier CSV, utilisez le format [keyword],[weight] où le poids est facultatif et peut être une valeur comprise entre -100 et 100. Utilisez des valeurs positives pour augmenter le score de violation et des valeurs négatives pour le diminuer.
Par exemple, si vous créez une politique DLP (Prévention des pertes de données) pour identifier les clés d'accès à AWS, votre dictionnaire de clés d'accès peut contenir les mots et phrases clés suivants avec des pondérations.
access key ID, 50
AWS, 10
AWS access key, 100
AWSAccessKeyId, 100
access keys
access, -20
Public Cloud, -100
Si vous avez créé une règle telle que C0 NEAR D0 où,
- C0 est un identifiant personnalisé
\b[A-Z0-9]{20}\b - D0 est le dictionnaire des clés d'accès.
Par exemple, s'il s'avère qu'un document contient les déclarations suivantes,
- “
Generate the access key“ - “
Enter the AWS access key ID AKIAIVLZMKR5WZSQO5ZA“
alors, le nombre de règles pour "Generate the access key" est zéro et le nombre de règles pour "Enter the AWS access key ID AKIAIVLZMKR5WZSQO5ZA" est un.
Le score total de violation pour ce document sera de 100.
Pour créer un dictionnaire New,
- Dans l'onglet Entité, cliquez sur New Entity. La boîte de dialogue Créer une entité s'affiche.
- Select Dictionary puis sélectionnez Keyword Dictionary ou RegEx Dictionary.

- Donnez un nom au dictionnaire et choisissez si le dictionnaire New est sensible à la casse ou non.
- Cliquez sur Select File. Localisez et sélectionnez votre fichier de dictionnaire, cliquez sur Open pour télécharger le fichier.
- Dans les options avancées, vous pouvez définir différentes conditions pour affiner les résultats lorsque ce dictionnaire est utilisé dans une règle DLP (Prévention des pertes de données). Pour plus d’informations, voir la section Options avancées .
Type de données
Data Types allow you to group the entities into clearly defined categories. You can select an existing one or create your own.
Sensitivity Level
Sensitivity Level allows you to set the criticality of the DLP Entity.
Options avancées
Les options avancées vous permettent de définir des conditions qui peuvent vous aider à limiter les résultats de la recherche de l'entité lorsqu'elle est utilisée dans une règle DLP (Prévention des pertes de données). Les options avancées sont les suivantes.
- Begins with, Ends with, Does not matchLe module de gestion des mots-clés : vous offre la possibilité d'ajouter des conditions pour inclure ou exclure des mots-clés ou des expressions rationnelles spécifiques.

- Use Filters - propose deux filtres : "Common-Sense" et "Unlikely Matches".
- Le filtre "Common-Sense" rejette une correspondance qui consiste principalement en des caractères répétitifs ou séquentiels. Par exemple, "
aabbcc" ou "22222". - Le filtre "Correspondances improbables" rejette une correspondance improbable en examinant les caractères présents avant ou après les données correspondantes. Par exemple, "
80*125752000=10060160000"ne contient probablement pas un numéro de sécurité sociale américain à 9 chiffres digne d'intérêt, et cette correspondance sera donc rejetée.
- Le filtre "Common-Sense" rejette une correspondance qui consiste principalement en des caractères répétitifs ou séquentiels. Par exemple, "
- Use Validators For Regex - propose trois options d'algorithmes de validation courants ("Luhn", "Elfproef" et "Verhoeff") pour rejeter les correspondances qui ne passent pas le contrôle de validation pour l'algorithme sélectionné.