

Overview
AI Guardrails ダッシュボードは、Netskope Advanced Analytics 内に構築された専用の監視画面であり、セキュリティチームが企業全体の GenAI アプリケーションにおけるプロンプトと応答、および AI 固有のセキュリティ ポリシーのパフォーマンスを可視化できるようにします。
Netskope One AI Guardrailsは、AIアプリケーションに送信されるすべてのプロンプトと、AIアプリケーションから受信されるすべての応答をリアルタイムで分析するランタイム防御レイヤーです。プロンプトインジェクションやジェイルブレイクなどの攻撃手法を検知してブロックし、有害または差別的なコンテンツ(ヘイトスピーチ、犯罪、武器など)をモデレートし、知的財産権や著作権の侵害を防ぎ、各検出結果をMITRE ATLASやOWASP Top 10 for LLMといった確立された業界フレームワークにマッピングすることで、セキュリティ運用チームが標準化された実用的なコンテキストを利用できるようにします。
ダッシュボードは、これらの検出結果と執行措置を集約し、構造化されたフィルタリング可能なビューに表示します。これは、以下のような業務を必要とする実務担当者にとって主要な操作インターフェースです。
- ガードレールポリシーの対象となるAIとのやり取りの量と性質を監視する
- ブロックされたトラフィックと監視対象(許可された)トラフィックのバランスを理解する
- 高リスクのコンテンツカテゴリ、一致するキーワード、および脆弱なアプリケーションを特定する
- 調査結果を MITRE ATLAS テクニックと SecOps の OWASP LLM リスクに合わせて調整するワークフロー
- ポリシーイベントを最も多く発生させている特定のユーザーまたはアプリケーションを調査します。
すべてのダッシュボードウィジェットは「アラート」データコレクションに基づいており、共通の グローバルフィルターセットを共有しています。これにより、アナリストは日付範囲、アクティビティタイプ、コンテンツカテゴリ、アプリケーション、ユーザーグループ、および個々のユーザーによって調査結果を絞り込むことができます。
データ属性
カスタムレポート作成とカスタマイズされた分析をサポートするために、Advanced Analytics の AI Guardrails アラートスキーマでは、以下のフィールドが利用可能です。
| ATTRIBUTE | デスクリプション |
|---|---|
| プロフィール名 | 検出時に適用されたガードレールの形状 |
| 一致するカテゴリ名 | 相互作用によって引き起こされるリスクカテゴリー |
| 一致するカテゴリレベル | 一致するカテゴリの重症度レベル |
| 一致するプロンプト/レスポンス | 検出を引き起こしたプロンプトまたは応答 |
| プロンプト/レスポンスレベルの一致 | 一致するプロンプトまたはレスポンスの深刻度レベル |
| 一致したキーワード | 検出をトリガーした特定のキーワード |
| OWASP Top 10 LLM | OWASP LLMリスク分類のマッピング |
| MITRE ATLAS | MITRE ATLAS技術をマッピングしました |
| 一致するコンテンツ | 一致したインタラクションの全内容 |
これらの属性は カスタムウィジェットやダッシュボードの構築、ターゲットフィルターの適用、または既存のビューへのAI固有の脅威コンテキストの追加に使用できます。
グローバルダッシュボードフィルター
ダッシュボード上のすべてのウィジェットには、以下のフィルターが含まれています。
| DISPLAY NAME | データ型 | デスクリプション |
|---|---|---|
| イベント開催日 | 日付フィルター | すべてのタイルを、ローリングまたは固定の時間枠内にスコープします。デフォルト値は過去30日間です。相対的な期間(例:過去7日間、過去90日間)を、相対期間UIコントロールを介してサポートします。 |
| 活動 | 文字列フィルター | AIとのやり取りの方向、具体的にはイベントがユーザーのプロンプト(投稿)によって生成されたのか、AIモデルの応答によって生成されたのかによってフィルタリングします。アナリストが、即時対応リスクと対応対応リスクを分離できるようにする。 |
| カテゴリ | 文字列フィルター | アプリケーションのカテゴリ(例:生成型AI、生産性向上)でフィルタリングします。分析対象をアプリ群の特定のセグメントに絞り込むのに役立ちます。 |
| 応用 | 文字列フィルター | 特定のアプリケーション名(例:ChatGPT、Google Gemini、Microsoft Copilot)でフィルタリングします。アプリごとのポリシーレビューとコンプライアンスレポート作成を可能にします。 |
| ユーザーグループ | 文字列フィルター | 組織のユーザーグループまたはディレクトリグループでフィルタリングします。部門、事業単位、またはリスクグループごとに的を絞った分析が可能になります。 |
| ユーザー | 文字列フィルター | 個々のユーザー ID (通常は電子メール アドレス) によってフィルターします。 インシデント対応におけるユーザーレベルの調査ワークフローを可能にします。 |
ダッシュボードウィジェットリファレンス
ダッシュボードには、環境内で検出されたプロンプトとレスポンスの概要が表示され、ユーザーが GenAI アプリにどれだけ頻繁にクエリを実行しているか、また、どれだけのトラフィックがブロック/許可されているかを理解するのに役立ちます。 このセクションでは、検出された上位のプロンプトカテゴリと一致するキーワードも表示されるため、リスクの高いプロンプトを特定し、これらのプロンプトを制御するためのポリシーをより適切に調整するのに役立ちます。
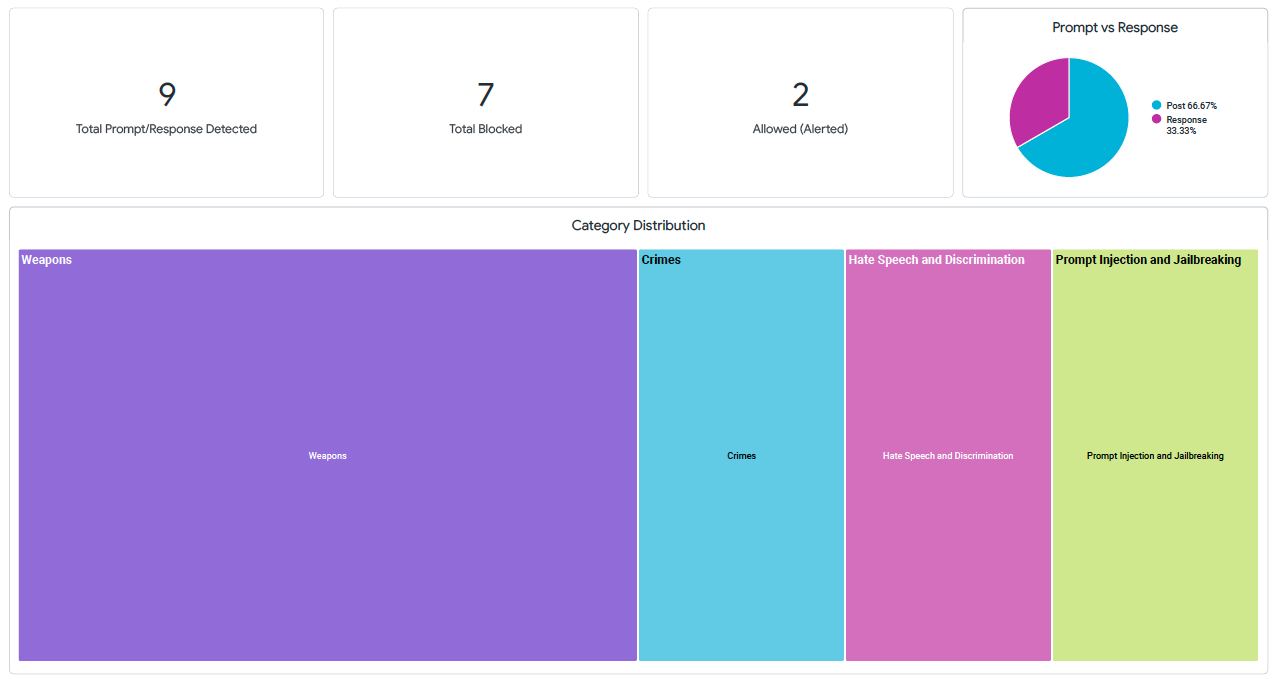
以下のセクションでは、ダッシュボードに表示される順序で各ウィジェットについて説明し、視覚化の種類、ビジネス目的、基盤となるロジック、およびNAA – AI Guardrailsスキーマフィールドについて解説します。 。
検出されたプロンプト/レスポンスの総数
デスクリプション
このウィジェットは、選択した期間中にAI Guardrailsエンジンによって検査され、フラグが立てられた個別のトランザクション(プロンプトとレスポンスを合わせたもの)の総数を表示します。これはダッシュボード上の主要なボリューム指標であり、組織全体におけるAIガードレール活動の基準となる規模を確立するものです。
ビジネスで使うケース
セキュリティリーダーと運用チーム このKPIにより、AIの使用状況全体を一目で把握できます。 カウントの増加は、AI 導入の拡大、新しいポリシーのトリガー、または新たな攻撃パターンを示している可能性があります。 これは、あらゆるガードレール関連の調査の出発点となり、また、AIセキュリティ監視の範囲を伝えるために経営幹部向けレポートで頻繁に 使用されます。
ブロックされたウィジェット合計
デスクリプション
このウィジェットは、ガードレールポリシーの適用によってアクティブなブロックアクション(つまり、プロンプトまたはレスポンスが宛先に到達するのを阻止されたアクション)が発生した個別のトランザクションの数を表示します。これは、単にログに記録されたのではなく、ポリシーによって停止されたやり取りの数を直接的に示す指標です。
ビジネスで使うケース
総ブロック数KPIは中核的な 有効性指標です。 検出総数に対するブロック数の割合が高いということは、ポリシーが監視のみのモードではなく、積極的な執行体制に設定されていることを示しています。セキュリティチーム この番号を使用して、リアルタイム保護が機能していることを検証し、 コンプライアンス関係者に対して執行の有効性について報告し、敵対的活動が活発な期間を特定します。 ブロック数の急増は、組織のAIツールを標的とした組織的な脱獄(ジェイルブレイク)または即時注入攻撃を示している可能性がある。
許可済み(監視対象)
デスクリプション
このウィジェットは、ガードレールエンジンがアクティビティを検出したものの、ポリシーアクションがブロックではなかった(つまり、ログ記録と監視は継続されながらも、インタラクションの進行が許可された)すべてのトランザクションをカウントします。これは、積極的な取り締まりというよりは、「警戒」または「容認」の姿勢を反映している。
ビジネスで使うケース
許可(監視)KPIは、合計ブロックウィジェットを補完するものであり、両者を合わせると組織のポリシー姿勢の区分を反映します。ブロックされた件数に比べて許可された件数が多いということは、組織が主に検出と監視モードにあることを示唆しており、これは初期導入段階やリスクの低いコンテンツカテゴリでよく見られる現象です。セキュリティチーム この指標を使用して、現在の 監視対象のリスクパターンに基づいて、アラートからブロックにエスカレーションすべきかどうかを評価します。 また、検査レイヤーを通過するAIトラフィックが停止することなくどれだけ流れているかを示すことで、キャパシティプランニングもサポートします。
迅速対応 vs 応答対応
デスクリプション
この円グラフは、検出されたトランザクションの総数を、ユーザーのプロンプト(投稿アクティビティ)によってトリガーされたものと、AIモデルの応答によってトリガーされたものの2つのセグメントに分類しています。各スライスは、それが全イベント数に占める割合を示しています。サンプルダッシュボードデータに基づくと、検出の約75%はプロンプトによるものであり、応答の約25%はプロンプトによるものである。
ビジネスで使うケース
リスクが主にユーザーの行動(プロンプト)に起因するのか、それともAIモデルの出力(応答)に起因するのかを理解することは、根本的に修復戦略を形成する上で重要である。警告メッセージが多く表示されるということは、ユーザーがポリシー違反の主な原因となっていることを示しています。これは、意図しない機密データの共有や、意図的な脱獄の試みなど、様々なケースが考えられます。回答が偏っている分布は、AIモデル自体に問題があり、有害、偏向的、または不適切なコンテンツを生成していることを示唆している。この図は、セキュリティ設計者が入力制御を強化するか、出力フィルタリングを強化するか、あるいはその両方を強化するかを判断するのに役立ちます。
カテゴリデスクリプションウィジェット
デスクリプション
カテゴリ分布ツリーマップは、ガードレール検出を引き起こしたコンテンツカテゴリの相対的な頻度を視覚化します。各長方形のサイズは、一致するカテゴリに関連付けられた個別の取引の数に比例します。サンプルデータで確認できるカテゴリには、武器、即時注射と脱獄、犯罪、ヘイトスピーチなどが含まれます。
ビジネスで使うケース
このウィジェットは、組織内におけるAIトラフィックのリスク状況構成を理解するための主要なツールです。これにより、有害またはポリシー違反のコンテンツの種類が最も蔓延しているかが即座に明らかになり、セキュリティチームはポリシーの調整、ユーザーへの意識向上トレーニング、およびエスカレーションの閾値を優先順位付けできるようになります。例えば、大規模な「Prompt Injection and Jailbreaking」ブロックは、組織のAIツールに対する活発な攻撃の試みを示しており、直ちに調査する必要がある。大規模なヘイトスピーチブロックは、技術的な対策に加えて人事部門の関与を必要とする文化的な問題を示している可能性があります。
トップキーワード一致ウィジェット
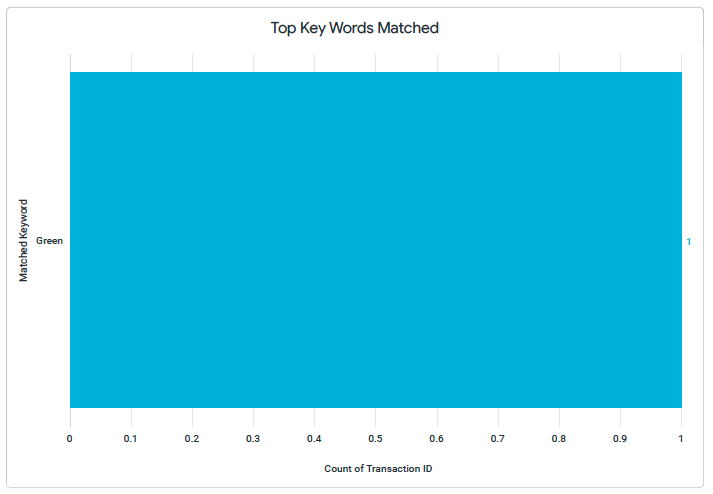
デスクリプション
この横棒グラフは、ガードレールポリシーの検出をトリガーした最も頻繁に一致するキーワードまたは用語を、トランザクション数の降順でランク付けしたものです。各棒グラフは特定のキーワードまたはフレーズを表し、その長さは、その用語を含む個別の取引の数を示しています。サンプルデータには、色を表すキーワード(緑、緑、青、青)とnull値が並んで表示されており、文字通りの危険語句を超えたパターンマッチングルールが存在することを示唆している。
ビジネスで使うケース
キーワード分析は、コンテンツ検査ポリシーの妥当性を検証し、調整する上で非常に重要です。色名などの無害な単語が目立つ場合、ポリシーのキーワードリストを精査して誤検出を減らす必要があることを示しています。逆に、非常に具体的な有害用語が頻繁に出現する場合は、組織的な悪用を示している可能性がある。セキュリティ管理者 このウィジェットを使用して、 AI Guardrailsプロファイル内のキーワード一致ルールを確認および最適化し、 効果的かつ正確であることを保証します。 また、脱獄やソーシャルエンジニアリングの試みにおける新たな言語パターンを特定するのにも役立ちます。
セキュリティフレームワーク – MITRE ATLASウィジェット
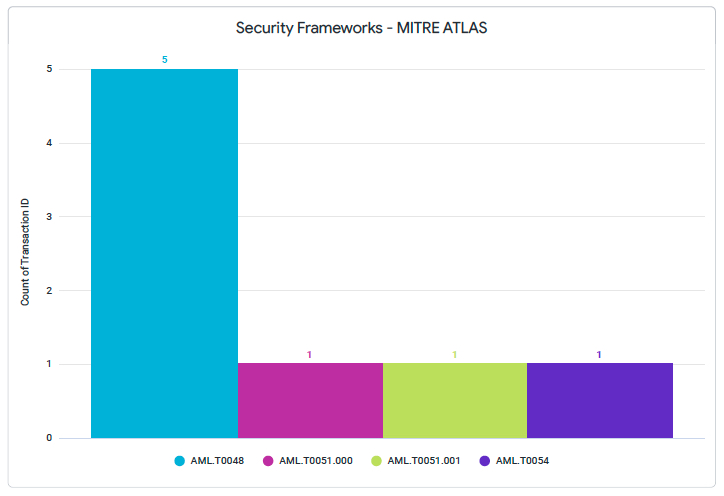
デスクリプション
この棒グラフは、ガードレール検出結果を特定のMITRE ATLAS(人工知能システム向け敵対的脅威状況)技術に対応付けたものです。各列はMITRE ATLASの技術IDを表し、その高さはその技術に関連付けられた個別のトランザクションの数を示します。サンプルデータには、AML.T0048、AML.T0051.000などの技術が示されています。AML.T0054、およびAML.T0051.001、即時注入、モデル反転、および敵対的入力に関連する技術を表す。
ビジネスで使うケース
MITRE ATLASとの整合性は、企業におけるAIセキュリティ運用の基盤となるものです。このウィジェットを使用すると、セキュリティオペレーションセンター(SOC)のアナリストと脅威インテリジェンスチームは、AI特有の攻撃を説明する際に、より広範なセキュリティコミュニティと共通の言語で話すことができます。 検出結果をATLASの技術にマッピングすることで、チームはAIガードレールの検出結果を脅威インテリジェンスフィードと関連付け、技術の深刻度と新規性に基づいて調査の優先順位を付け、コンプライアンスに対応したレポートを作成できます。また、同業他社とのベンチマークを実施したり、すでに MITRE フレームワークを活用している既存の SIEM や SOAR ワークフローに AI セキュリティの調査結果を統合したりすることも可能になります。
セキュリティフレームワーク – OWASPトップ10 LLMウィジェット
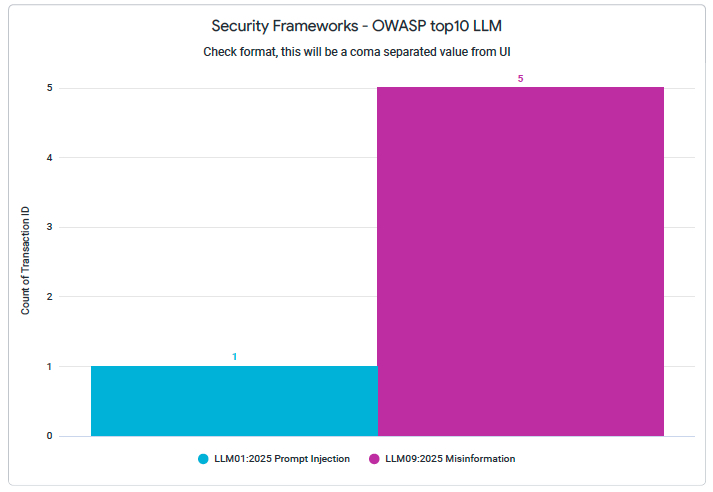
デスクリプション
この棒グラフは、ガードレールによる検出結果を、大規模言語モデルアプリケーション(LLMA)のリスクカテゴリであるOWASP Top 10にマッピングしたものです。各列はOWASP LLMリスク識別子を表し、その高さはトランザクション数を反映しています。サンプルデータによると、LLM09:2025 誤情報と LLM01:2025 即時注入が上位のリスクとして示されており、null カテゴリも存在します。このウィジェットには、OWASPリスク値がUIからカンマ区切りの文字列として送られてくるため、フォーマット検証が必要であることを示す開発者向け注記が含まれています。
ビジネスで使うケース
OWASP Top 10 for LLMsは、アプリケーション開発および企業におけるAIリスク管理において、最も広く参照されているAIセキュリティフレームワークの1つです。このウィジェットは、運用上の検出データを世界的に認知されているリスク分類体系に直接接続することで、セキュリティおよびコンプライアンスチームが、組織のAI利用においてどのOWASPリスクが最も蔓延しているかを評価できるようにします。リスク登録簿の維持管理、取締役会レベルの報告、および規制遵守の取り組みを支援します。SOCチームも このウィジェットをMITRE ATLASチャートと併用することで、攻撃者の手法(ATLAS)と、それによって生じるアプリケーション層のリスク(OWASP)の両方を包括的に把握できます。
許可済み vs ブロック済みウィジェット
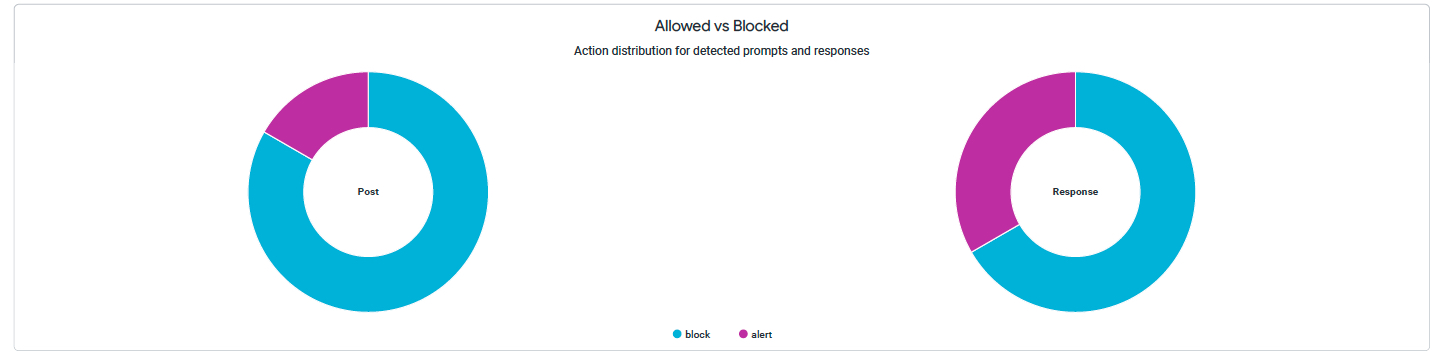
デスクリプション
この全幅ビジュアライゼーション 「ドーナツマルチプル」チャートタイプを使用して、活動タイプ(プロンプト対レスポンス)別に分類された執行措置(許可対ブロック)の分布を表示します。 各ドーナツは1つのアクションカテゴリを表し、アクティビティごとに細分化されているため、 プロンプト方向とレスポンス方向の両方における姿勢を同時に確認できます。 添付の注記:検出されたプロンプトと応答に対するアクションの分配。
ビジネスで使うケース
「許可済み vs ブロック済み」ウィジェットは、最上段のKPIカードでは得られない、より詳細なポリシー状況の表示を提供します。活動の種類ごとにブロック/許可の比率を分析することで、ブロックがプロンプトとレスポンスの両方に一貫して適用されているのか、それとも一方の方向に集中しているのかが明らかになります。例えば、組織はポリシー調整段階で、プロンプトではすべての脱獄試行をブロックする一方で、応答では有害なコンテンツのみを監視(許可)するといった設定を行う可能性がある。この詳細な情報は、 管理者が非対称的な執行上のギャップを特定し、管理を強化する優先順位を決定するのに役立ちます。 また、これは、実施された措置と監視された措置の文書化された証拠を必要とするコンプライアンスレビューにとって重要な成果物でもあります。 措置。
ポリシー別のトップアプリケーション実行アクションウィジェット
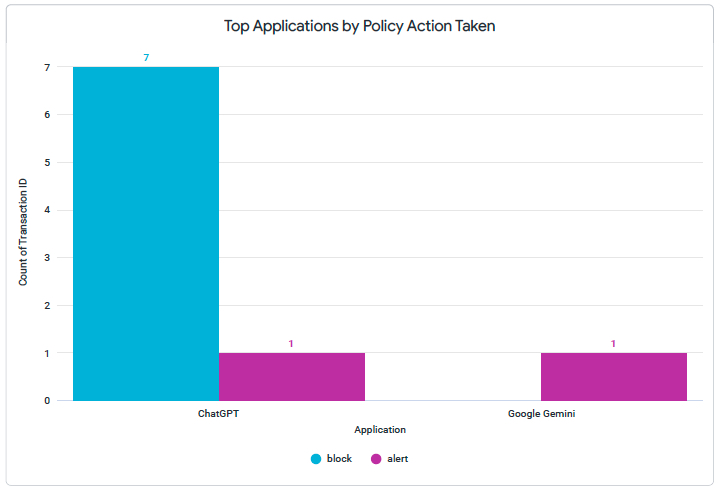
デスクリプション
この積み上げ棒グラフは、 AI Securityガードレールイベントを生成する上位10のアプリケーションを示しており、各列は、実行されたさまざまな強制措置(ブロック、警告、許可)を表す積み上げセグメントに分割されています。 これにより、アプリケーション全体におけるイベントの総量とアクションの分布を直接比較することが可能になります。サンプルデータによると、ChatGPTでは13件、Google Geminiでは3件の検出が報告されています。
ビジネスで使うケース
リスクベースのAIガバナンスには、アプリケーションレベルの可視性が不可欠です。このウィジェットは、「どのAIアプリケーションが最も多くのポリシーイベントを生成しているのか、そしてそれらはブロックされているのか、それとも単に監視されているだけなのか?」という疑問に答えます。大量のトラフィックがあり、「許可」セグメントが大きいアプリケーションは、より厳格な 一方、トラフィックの大部分がブロックされているアプリケーションは、ユーザーアクセスレビューまたは完全な ブロックの対象となる可能性があります。 セキュリティ チームは、AI ツール (Microsoft Copilot など) のリスク プロファイルを未承認のアプリケーション (シャドウ AI) と比較し、アプリケーション固有の認可ガードレール ポリシーのビジネス ケースを構築するためにこのウィジェットも使用します。
ポリシー別のトップユーザー 実行されたアクション
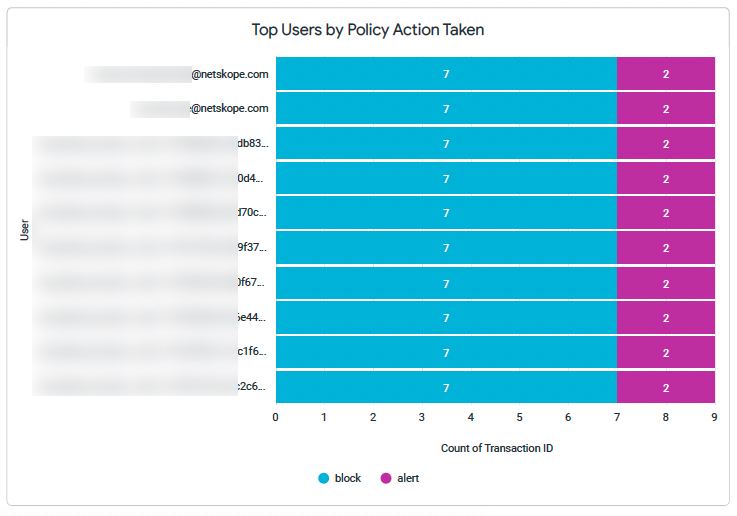
デスクリプション
この横棒グラフは、 AI Securityガードレールイベントを生成した上位10ユーザーを示しており、各棒は実行された対策ごとに区分されています。 行合計は基となるデータに含まれています(ただし、グラフ表示では非表示になっています)。ユーザーは、イベントの総数が多い順にランク付けされます。サンプルデータによると、ayang@netskope.comが最多の検出ユーザーであり、合計16件の検出が行われ、すべて検出アクションタイプに分類されています。
ビジネスで使うケース
ユーザーレベルでの帰属特定は、インシデント対応と内部リスク対策の両方にとって極めて重要です。このウィジェットは、セキュリティポリシーが発動されるような形でAIシステムと最も頻繁にやり取りするユーザーを表示します。大量利用ユーザーについては、その活動が良性(例えば、AIツールを合法的に使用しているパワーユーザー)なのか、悪意のあるもの(例えば、データ漏洩の試みや執拗な脱獄キャンペーン)なのかを判断するために調査が必要である。ユーザーごとのアクションの内訳を見ると、特定の個人がアクティブなブロックの対象になっているのか、それとも監視されているだけなのかが明らかになる。これは、エスカレーションの判断において重要な区別となる。このウィジェットは、人事担当者によるリスク レビュー、セキュリティ意識のターゲティング、アクセス ポリシーの適用にも使用されます。
NAA – AI Guardrailsスキーマリファレンス
以下の表は、AI Guardrailsスキーマの主要フィールドを示しています。
| プロファイル名(ポリシーに一致したプロファイル名) | データ型 | デスクリプション |
|---|---|---|
| 一致するカテゴリ | Dimension | アラートをトリガーした、定義済みのカテゴリに一致しました。 |
| 一致するプロンプト/レスポンス | Dimension | アラートをトリガーしたプロンプトまたはレスポンスが一致しました。 |
| 一致したキーワード | Dimension | アラートをトリガーしたキーワードが一致しました。 |
| OWASP top10 LLM | Dimension | 生成型AIシステムにおける最も重大なセキュリティ脆弱性を特定するための標準的なフレームワーク。 |
| MITRE ATLAS | Dimension | 人工知能システムに対する敵対的脅威の状況は、人工知能(AI)および機械学習(ML)システムにおける実際の攻撃と理論上の脆弱性に基づいた、敵対者の戦術と技術に関する知識ベースです。 |
付録 — フレームワーク参照
MITRE ATLAS 技術の参照
以下のMITRE ATLAS技術IDはダッシュボードデータに表示され、アナリストの参考のためにここに記載されています。
| NAME | データ型 | デスクリプション |
|---|---|---|
| バックドアMLモデル | Technique | 機械学習モデルの重みや訓練データを敵対的に操作し、特定の入力によって作動する隠れたバックドアを作成する。 |
| LLM プロンプトインジェクション | Sub-technique | ユーザープロンプトに埋め込まれた悪意のあるコンテンツがLLMのシステム指示を上書きし、LLMが本来の意図された範囲外で動作するようにする。 |
| 間接的即時注射 | Sub-technique | 攻撃的な指示は、ユーザープロンプトに直接挿入されるのではなく、LLMが処理する外部コンテンツ(ウェブページ、文書、電子メール)を介して注入される。 |
| LLM脱獄 | Technique | LLMに組み込まれた安全ガードレールを回避し、プログラム上拒否するように設定されている出力を強制的に生成させるための技術。 |
OWASPトップ10 LLMリスクを参照
ダッシュボードデータには、以下のOWASP Top 10 for LLM Applications (2025) リスクカテゴリが表示されます。
| NAME | データ型 | デスクリプション |
|---|---|---|
| 即時注射 | 重大なリスク | システムプロンプトを上書きしたり、モデルのコンテキストウィンドウに不正な指示を注入したりすることで、LLMの動作を操作する悪意のある入力。 |
| Misinformation | 高リスク | LLM(法執行機関)は、事実であるかのように提示される虚偽、誤解を招く、または幻覚的なコンテンツを生成し、結果として損害、法令遵守上の問題、または評判の低下を引き起こす。 |