

Overview
Netskope Log StreamingをSplunk Cloudアドオン(AWS TA、MSCS TAなど)を介して統合すると、ウェブトランザクションログがJSON形式で取り込まれます。 これにより、Splunk はキーと値のペアを使用するフィールドを自動的に抽出できるようになり、検索性と使いやすさが向上します。
ただし、CSV ヘッダーなしで生のウェブ トランザクション ログ データのみが取り込まれるNetskope TA や非推奨のウェブ イベント ストリーミング パイプラインとは異なり、JSON 形式には値とともにフィールド名が含まれます。 その結果、Splunkに取り込まれるデータ総量が増加し、ライセンス費用が高くなる可能性があります。
この問題を解決するために、入力設定を変更してログをJSON形式ではなく生のCSV形式で取り込むようにすることで、取り込み量を最適化するオプションがあります。
摂取量を減らす
取り込まれるデータ量を減らすには、入力設定でオプションParse all files as CSVを無効にしてください。
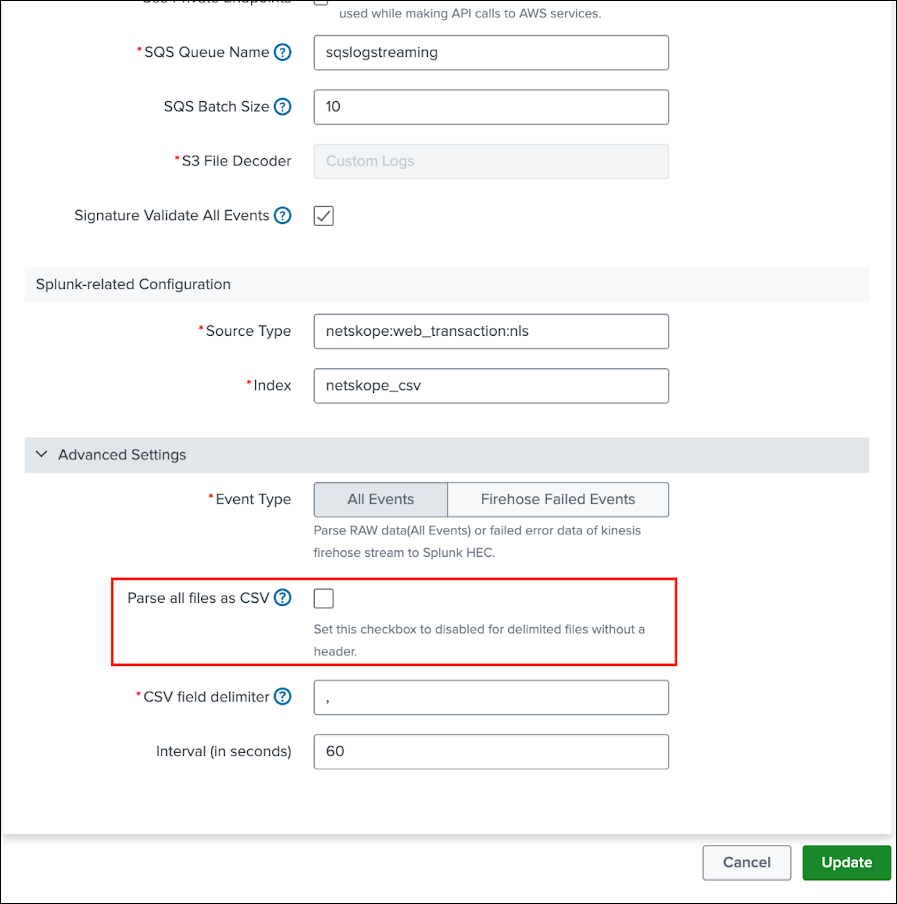
この変更により、ログのJSON形式への変換が停止され、代わりにログを元のCSV形式で取り込むことができるようになります。その結果、摂取量全体が大幅に減少し、関連コストの削減にもつながります。
重要な考慮事項
この方法は摂取コストの削減に役立つ一方で、いくつかのトレードオフも伴う。自動フィールド抽出機能は利用できなくなり、ログはSplunk上で解析されていない生データとして表示されます。そのため、要件に基づいてフィールド抽出を手動で設定する必要があります。
手動によるフィールド抽出(変更後に必要)
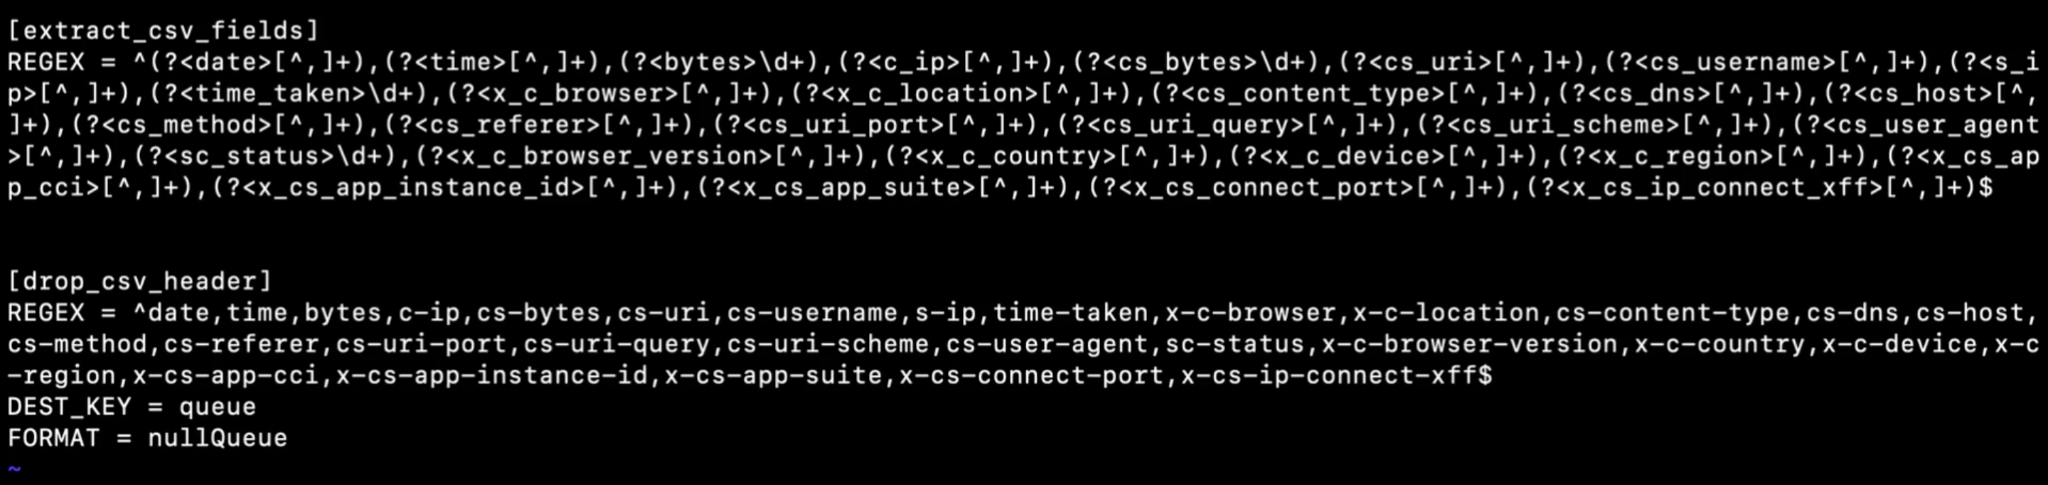
フィールド抽出は自動的に行われなくなるため、解析ルールを定義する必要があります。 Splunkの設定例:
- props.conf
- transforms.conf
Netskopeログの構造は、テナントのログストリーミング設定で選択されたフィールド、およびそれらのフィールドが定義されている順序によって決まることに注意してください。
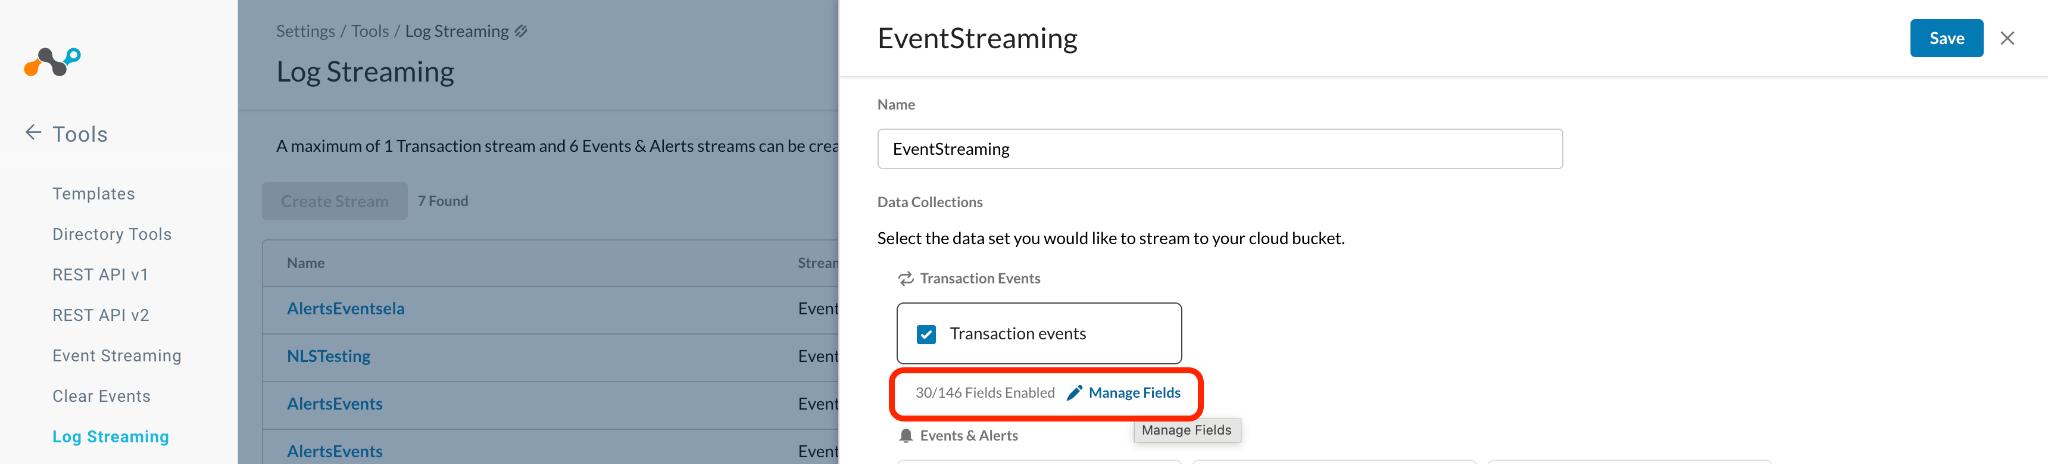
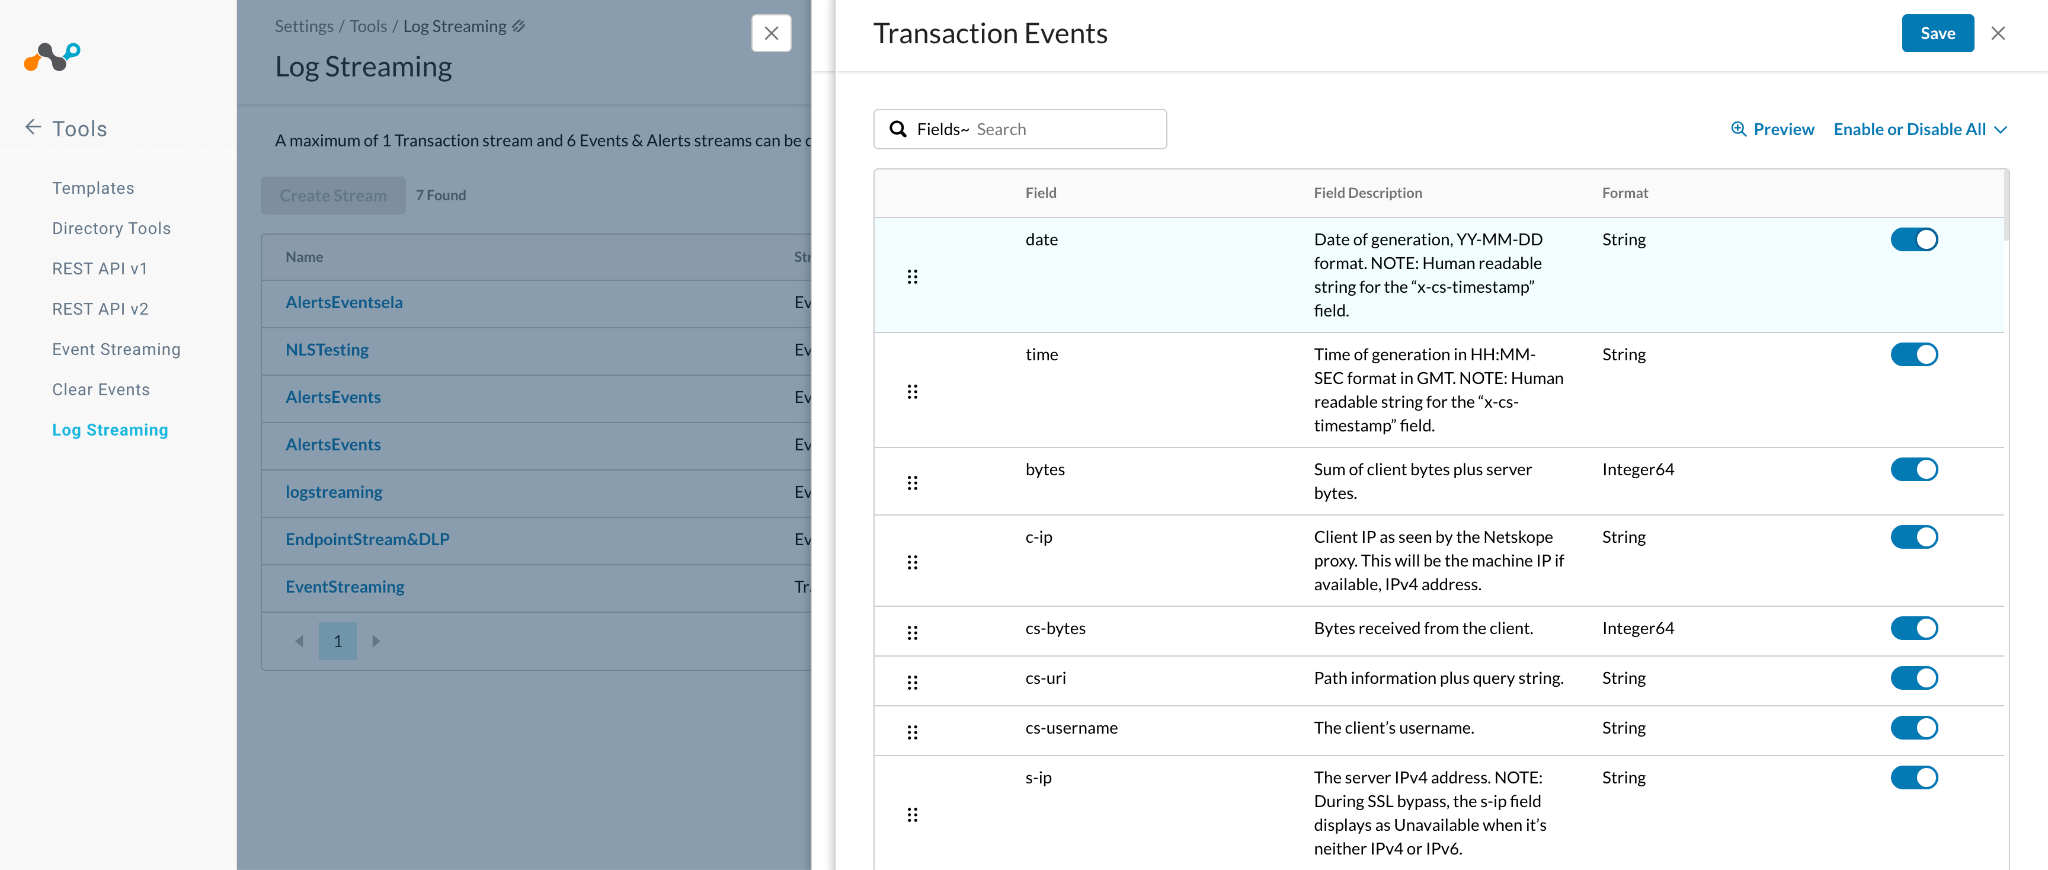
そのため、万能な解析設定は存在しません。特定の構成に基づいて、フィールド抽出ルールを作成し、カスタマイズする必要があります。
生ログの操作:フィールド抽出ガイド
始めるにあたって役立つ基本的な手順をいくつかご紹介します。
ステップ1:正規表現ファイルと設定ファイルの生成
ChatGPTのようなAIアシスタントツールを使用して、必要な正規表現とSplunk構成ファイルを自動的に生成します。
- CSVヘッダーとサンプルログエントリを提供してください。
- Netskopeで設定されているとおり、フィールドヘッダーがexact orderにリストされていることを確認してください。
- 次の構造化プロンプトを使用します。
Prompt:
次のようなヘッダーを持つ CSV ログがあります: date,time,bytes,c-ip,cs-bytes,cs-uri,cs-username,s-ip,time-taken,x-c-browser,x-c-location,cs-content-type,cs-dns,cs-host,cs-method,cs-referer,cs-uri-port,cs-uri-query,cs-uri-scheme,cs-user-agent,sc-status,x-c-browser-version,x-c-country,x-c-device,x-c-region,x-cs-app-cci,x-cs-app-instance-id,x-cs-app-suite,x-cs-connect-port,x-cs-ip-connect-xff サンプルログ: 2026-03-19,06:17:43,2600,172.31.30.26,2315,-,user@company.com,16.16.109.171,58,Native,Stockholm,application/json,example.com,example.com,POST,-,443,-,https,agent,200,-,SE,Windows,Stockholm,-,-,-,-,- 要件: 1. すべてのフィールドに対して名前付きキャプチャ グループを持つ REGEX を生成します。 2. Splunkの設定を出力します:props.conf transforms.conf 3. 正規表現が本番環境で使用可能で効率的であることを確認します。 4. 動的な列順序を想定しないでください(固定順序のみ)。 5. transforms.conf に nullQueue フィルタを追加して、ヘッダー行を削除します(raw event にヘッダー行が含まれている場合)。 出力形式: Regex props.conf transforms.conf |
期待される結果
- 名前付きキャプチャグループを備えた、実運用に対応した正規表現。
- 正しくフォーマットされた
props.confとtransforms.conf。
ステップ2:Netskopeアドオンの設定を更新します。
- Netskope TA のローカルディレクトリに移動します:
$SPLUNK_HOME/etc/apps/TA-NetskopeAppForSplunk/local/ - 以下のファイルを作成または更新します。
- props.conf
- transforms.conf
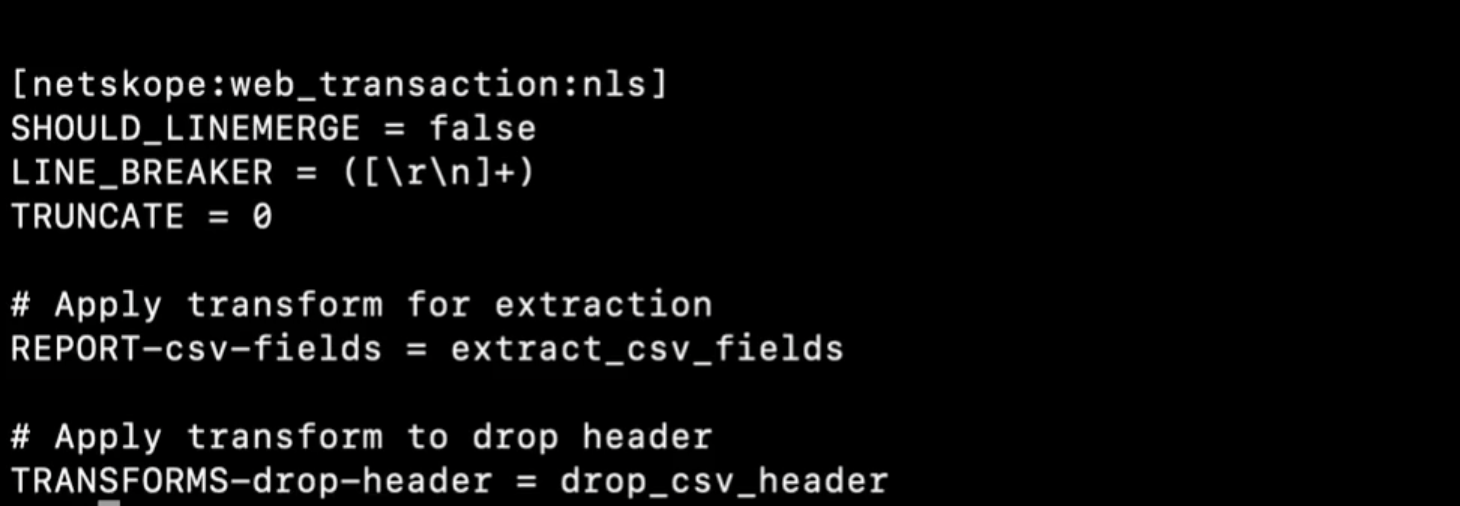
sourcetype:[netskope:web_transaction:nls]に新しいスタンザを追加します- 生成された設定をそれぞれのファイルに挿入してください。
- 入力構成の下に、UI から新しい
sourcetypeをnetskope:web_transaction:nlsとして追加します。
期待される結果
- SplunkはNetskopeログを解析するように設定されています 定義された正規表現。
- ヘッダー行はフィルターで除外されます 使う
nullQueue。
Sample stanza for props.conf
Sample stanza for transforms.conf
ステップ3:Splunkを再起動して検証する
Splunk Enterpriseを再起動してください。.
期待される結果
- ログは、フィールドを含まないCSV形式で正常に取り込まれる必要があります。
- フィールドは正しく抽出され、検索可能です。
- ヘッダー行はインデックス作成の対象外です。
このプロセスを説明するビデオはこちらです。
検証とベストプラクティス
- Validate field extraction using Splunk search:
index=<your_index> | table * - 初期データ取り込み量を削減するには、Netskopeのユーザーインターフェース内で不要なフィールドを削除してください。
- Netskopeからrequired fieldsのみをストリーミングします。新しいパーサーの作成が必要となる以下の点に注意してください。
- 野戦順序。
- Netskope Log Streamingの設定における今後の変更点。