

Netskope DLPでは、 Entitiesデータ識別子とデータ辞書を指します。データ識別子は、特定の種類の識別可能なデータを分類するために使用されるよくある用語であり、辞書はキーワードと正規表現を含むファイルです。 エンティティは、機密データを識別するためのルールで使用されます。
NetskopeはPredefined AI Entitiesも提供しており、固有表現抽出(NER)を使用して、パターンマッチングだけでは確実に検出できない構造化されていない文脈データ(名前やゲノム識別子など)を検出します。これには追加ライセンスが必要です。NERベースのエンティティの仕組みと、それらをルールで使う方法の詳細については、Select Predefined Entitiesを参照してください。
Netskope UI でエンティティ ページを開くには、 Policies > Profiles > DLP > EDIT RULESに移動してData Loss Preventionを選択します。次に、 Entitiesタブをクリックします。

事前定義エンティティ
Netskopeは、意味のある名前とデスクリプションを持つ幅広い定義済みエンティティリストを提供しています。事前定義済みエンティティの完全な一覧は、「新しいDLPルール」ワークフローで確認できます。
事前定義されたエンティティの完全なリストを表示するには、[データ漏洩防止ルール]ページの[ルール]タブで[New Rule]をクリックします。[新しいDLPルール]ダイアログボックスでは、すべての事前定義済みエンティティがカテゴリの下にリストされています。

独自のカスタムエンティティも作成できます。
カスタムエンティティを作成するには、
- 「エンティティ」タブで、 NEW ENTITYをクリックします。「エンティティの作成」ダイアログボックスが表示され、 Data identifierオプションが選択されています。
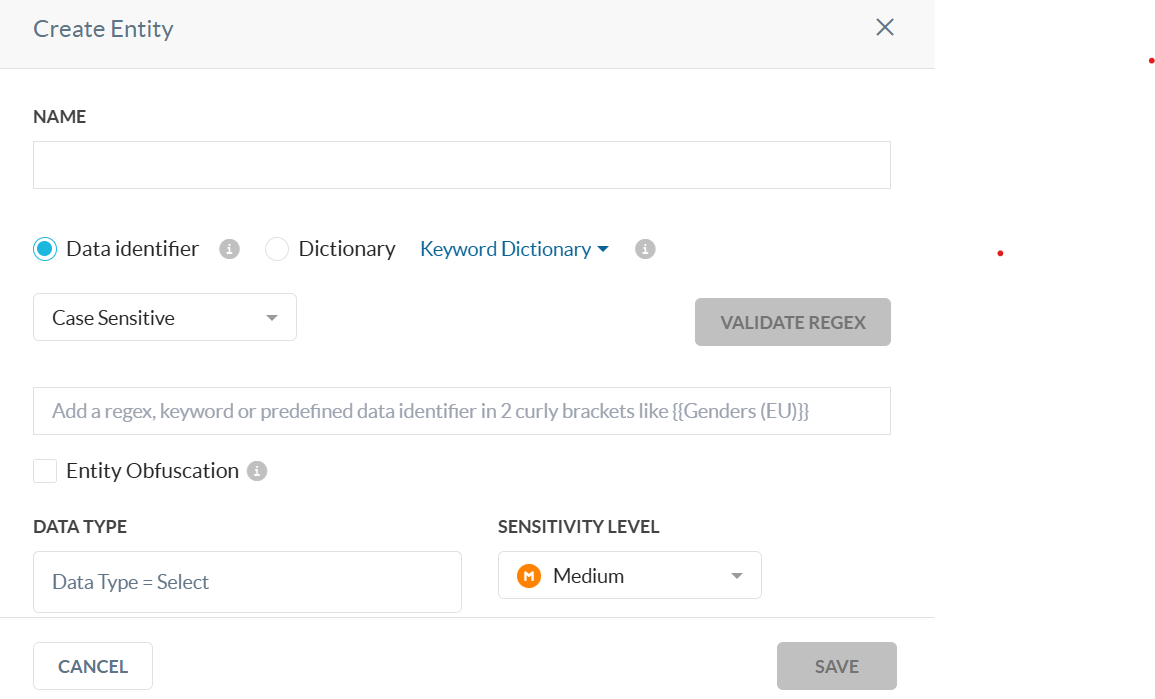
- カスタムエンティティの名前を指定し、新しいエンティティで大文字と小文字を区別するかどうかを選択します。
{{predefined_data_identifier}}の形式の事前定義エンティティ、キーワード、または正規表現を追加します。たとえば、{{Full Names (US)}}などの事前定義済み識別子、Nameなどのキーワード、または[0-9]{5,10}Validate Regex ボタンをクリックして、正規表現の構文を検証します。正規表現でサポートされている演算子、量指定子、およびメタ文字の詳細については、正規表現の構築を参照してください。
- 既存のData TypeをSelectか、新しいData Typeを作成します。
- SelectSensitivity Level。
- 高度なオプションでは、このエンティティが DLP ルールで使用される際に結果を絞り込むためのさまざまな条件を設定できます。詳細については、 高度なオプション セクションを参照してください。
エンティティの削除
Entity Redaction (旧 称Entity Obfuscation)は、DLPプロファイル内でエンティティマッチによって検出された機密情報を編集するデータ非同一化機能です。
Entity Redactionを有効にすると、このエンティティの一致データは DLP のインシデントフォレンジックデータ内で難読化されます。いずれの難読化/マスキング方法においても、一致するマスキングされた文字の数が5未満であれば、すべての数字および/または文字がマスキングされます。
Deprecated:

Updated:

インシデントフォレンジック:フォレンジックのワークフローは変更されません。システムは、一切の変更を加えることなく、インシデント記録と専用のフォレンジックビューを引き続きサポートします。
Configuration Steps
- 事前定義済みエンティティ – 暗黙的マスキング
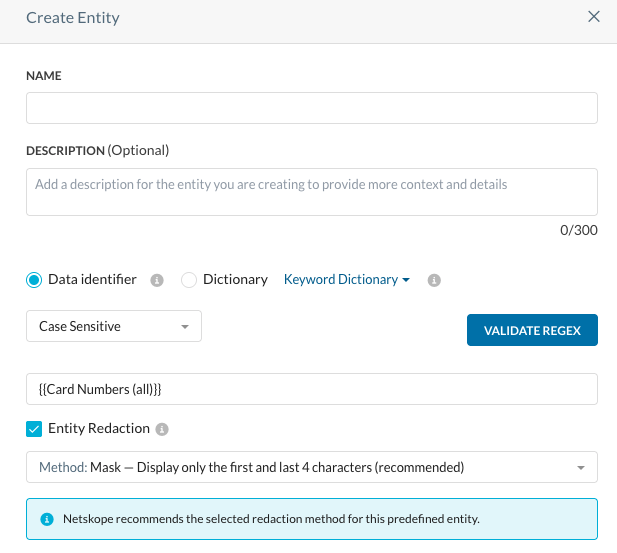
あらかじめ定義されたエンティティをクローンすると、Netskopeは自動的にエンティティの編集を有効にし、そのエンティティに推奨されるマスキング方法を選択します。次の例は、カード番号(すべて)エンティティを複製した後の「エンティティの作成」ダイアログボックスを示しています。メソッド欄にはマスクが表示されます — 最初と最後の4文字のみを表示する(推奨)。情報バナーでNetskopeがこのメソッドを事前に定義されたエンティティに推奨していることが確認されます。
- カスタムエンティティ – カスタムマスキング機能を追加します

- インシデントフォレンジック
名前: John Smith
XXX: XXX-XX-XXXX
電子メール: john.smith@example.com
生年月日:1985年3月15日
フィルター
Filters 可能性が低い、またはあり得ないマッチングは拒否する。事前定義されたEntitiesには特別な考慮事項があります。
Use Filters — 「よくある意味」と「よく一致しない」という 2 つのフィルターを提供します。
- 定義済みのEntityにフィルターが設定されていない場合、 Use FiltersとUse Validator for Regexオプションはグレー表示されます。
- 定義済みのEntity 2つのフィルターのうち1つしか含まれていない場合、 Use Validator For Regexオプションはグレー表示され、選択された定義済みエンティティのデフォルトのバリデーターが適用されます。
- 定義済みのEntityに両方のフィルターが含まれている場合、 Use Filtersと、その下にある両方のフィルターがチェックされます。Use Validator for Regexオプションはグレー表示されます。
Netskopeは、特定のスキーマにおいて、フォント、色、行折り返し、間隔などの要素を考慮したテキスト正規化をテキスト抽出プロセスに統合します。この正規化は、検出精度を高めるだけでなく、テキストベースのステガノグラフィーに対する機能的な対策としても役立つ可能性がある。
Dictionary
辞書は、キーワード辞書または正規表現辞書のいずれかである。辞書ファイルは、検索したいキーワードやフレーズ、または正規表現を含むことができるCSVファイルです。 DLPルール。 各辞書ファイルには、キーワードやフレーズ、または正規表現のいずれかを含めることができます。
辞書ファイルを使うには、1行あたり1つのキーワード、フレーズ、または正規表現を含んだCSVファイルを作成します。正規表現辞書ファイルには、最大25個のエントリを含めることができます。正規表現でサポートされている演算子、量指定子、メタ文字の詳細については、 「正規表現の構築」を参照してください。
Netskopeは、各キーワードまたはフレーズに重みを指定できる重み付き辞書もサポートしています。キーワードの重みとは、違反スコアを計算する際に基準となる数値のことです。ルール違反スコアは、ルールカウントの重みの合計であり、ルールカウントとは、ルールが一致した回数のことです。キーワードの重要度が高いほど、違反スコアも高くなります。違反スコアは、違反が発生した場合にルールを発動するタイミングを決定します。 重みが指定されていない場合、キーワードまたはフレーズにはデフォルトで重み1が割り当てられます。
注記
正規表現には重みは割り当てられません。
CSVファイルでキーワードを定義するには、 形式は[keyword],[weight]で、weightはオプションであり、-100から100までの任意の値を指定できます。正の値は違反スコアを増加させ、負の値は違反スコアを減少させます。
例えば、AWS アクセスキーを識別するための DLP ポリシーを作成する場合、アクセスキー辞書には、重み付けされた以下のキーワードとフレーズを含めることができます。
access key ID, 50
AWS, 10
AWS access key, 100
AWSAccessKeyId, 100
access keys
access, -20
Public Cloud, -100
C0 NEAR D0 のようなルールを作成した場合、
- C0 は、AWS アクセスキー ID を識別するためのカスタム識別子
\b[A-Z0-9]{20}\b - D0はアクセスキー辞書です。
例えば、文書に以下の記述が含まれている場合、
- “
Generate the access key“ - “
Enter the AWS access key ID AKIAIVLZMKR5WZSQO5ZA“
すると、「 Generate the access key 」のルール数はゼロになり、「 Enter the AWS access key ID AKIAIVLZMKR5WZSQO5ZA 」のルール数は1になります。
この文書の違反点数は合計100点となります。
新しい辞書を作成するには、
- エンティティ タブでNew Entityをクリックします。「エンティティの作成」ダイアログボックスが表示されます。
- Select Dictionary してから Keyword Dictionary または RegEx Dictionaryを選択します。

- 辞書の名前を入力し、新しい辞書がケースを区別するかどうかを選択します。
- Select Fileをクリックしてください。辞書ファイルを見つけて選択し、 Openをクリックしてファイルをアップロードします。
- 詳細オプションでは、この辞書が DLPルールで使用される場合に結果を絞り込むためのさまざまな条件を設定できます。 詳細については、 「詳細オプション」セクションを参照してください。
データ型
データ型を使用すると、エンティティを明確に定義されたカテゴリに分類できます。既存のものを選ぶことも、自分で作成することもできます。
感度レベル
感度レベルを使用すると、DLPエンティティの重要度を設定できます。
詳細オプション
詳細オプションを使用すると、DLPルールでエンティティの検索結果を絞り込むのに役立つ条件を設定できます。 DLPルールで。 以下は詳細設定オプションです。
- Begins with, Ends with, Does not match特定のキーワードや正規表現を含めるか除外するかの条件を追加するオプションを提供します。

- Use Filters — 「よくある意味」と「よく一致しない」という 2 つのフィルターを提供します。
- 「よくあるセンス」フィルターは、主に反復文字または連続文字で構成される一致を拒否します。 例えば、「
aabbcc」や「22222」など。 - 「一致しない可能性が高い」フィルターは、一致したデータの前後に存在する文字を調べることで、一致しない可能性が高いデータを拒否します。例えば、「
80*125752000=10060160000"はおそらく9桁の米国社会保障番号は含まれていないため、この一致は拒否されます。」
- 「よくあるセンス」フィルターは、主に反復文字または連続文字で構成される一致を拒否します。 例えば、「
- Use Validators For Regex — 3 つの 検証アルゴリズムオプション(「Luhn」、「Elfproef」、「Verhoeff」)を提供し、選択したアルゴリズムの検証チェックに合格しない一致を拒否します。