

Ce document est destiné à toute personne souhaitant analyser les informations relatives au chemin de réseau, en particulier les rapports Traceroute, et déterminer si le chemin de réseau a ou non un effet important sur l'expérience de l'utilisateur.
Le diagnostic de réseau basé sur Traceroute entraîne un taux élevé de faux positifs. Cela est principalement dû à une mauvaise interprétation des mesures dans les rapports Traceroute. Ce document a pour but d'aider à interpréter les rapports Traceroute avec précision et de réduire les diagnostics faussement positifs.
Qu'est-ce que Traceroute ?
Traceroute est l'outil principal pour résoudre les problèmes sur Internet. Il s'agit d'un utilitaire de ligne de commande qui, lorsqu'on lui donne une adresse IP ou un nom d'hôte, affiche une liste des sauts de routeur entre la source et la destination, ainsi que les mesures associées telles que la latence, les paquets perdus et les détails du routeur.
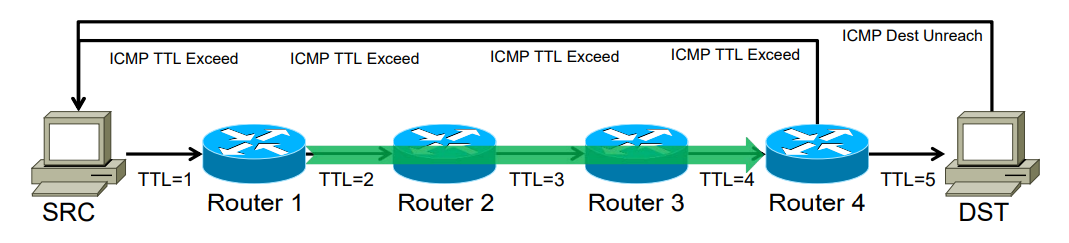
Brève présentation de Traceroute :
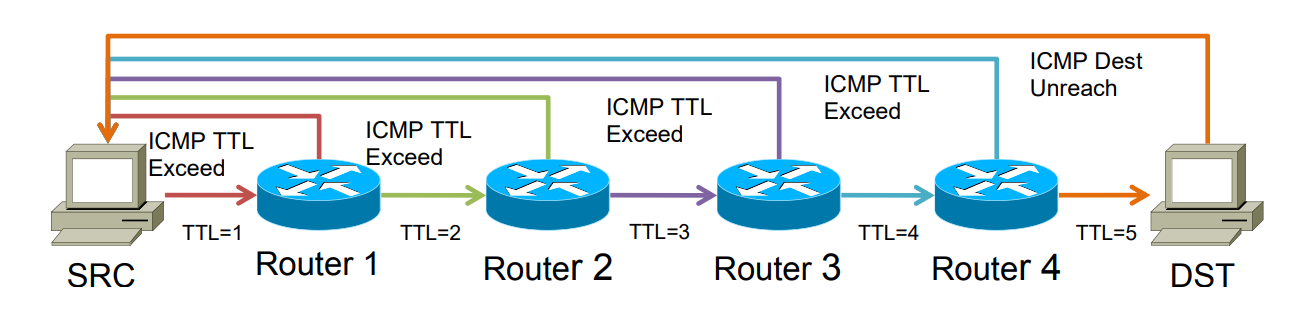
- Le périphérique source (SRC) lance un paquet de sonde vers le périphérique de destination (DST), avec un TTL de 1.
- Chaque saut de routeur diminue le TTL du paquet de 1.
- Lorsque le TTL atteint 0, le paquet est abandonné et le routeur envoie un paquet "ICMP TTL Exceeded" au SRC avec le paquet de sonde original en tant que charge utile.
- Le SRC reçoit ce message ICMP et affiche un Traceroute "hop".
- L'opération est répétée à partir de l'étape 1, la valeur TTL étant augmentée de 1 à chaque fois jusqu'à ce que l'hôte DST reçoive un paquet de sonde.
- Lorsque l'hôte DST reçoit le paquet de sonde, il renvoie "ICMP Dest Unreachable".
- Le SRC arrête le Traceroute à la réception du message "ICMP Dest Unreachable".
- Si le DST ne reçoit jamais de paquet de sonde ou ne répond jamais à un paquet de sonde, traceroute s'arrête généralement après un certain nombre de tentatives infructueuses.
Exemple de sortie (Linux) :
Traceroute to www.ntt.net (130.94.58.116), 64 hops max, 52 byte packets
1 ge0-34.aggrFZ155-2.ord6.us.scnet.net (204.93.176.73) 4.558 ms 2.030 ms 2.730 ms
2 ge9-47.ar1.ord6.us.scnet.net (75.102.0.65) 0.405 ms 0.297 ms 0.265 ms
3 61.po4.ar1.ord1.us.scnet.net (75.102.3.225) 1.305 ms 1.249 ms 1.232 ms
4 ae0-81.cr1.ord1.us.nlayer.net (69.31.111.1) 1.135 ms 59.441 ms 1.144 ms
5 ae1.ar2.ord1.us.nlayer.net (69.31.111.146) 1.419 ms 2.249 ms 1.452 ms
6 as2914.xe-6-0-3.ar2.ord1.us.nlayer.net (69.31.111.233) 1.450 ms
  as2914.xe-6-0-2.ar1.ord1.us.nlayer.net (69.31.111.209) 1.608 ms
  as2914.xe-6-0-3.ar2.ord1.us.nlayer.net (69.31.111.233) 1.497 ms
7 ae-7.r21.chcgil09.us.bb.gin.ntt.net (129.250.4.201) 9.476 ms
  ae-6.r21.chcgil09.us.bb.gin.ntt.net (129.250.2.26) 1.389 ms 9.325 ms
8 ae-5.r20.snjsca04.us.bb.gin.ntt.net (129.250.3.107) 52.695 ms 54.304 ms 57.892 ms
9 ae-1.r06.snjsca04.us.bb.gin.ntt.net (129.250.5.13) 54.316 ms 54.275 ms 52.426 ms
10 130.94.58.116 (130.94.58.116) 52.211 ms 58.061 ms 54.065 ms
Outils communs
- Traceroute UNIX classique, qui utilise des paquets UDP avec des ports de destination commençant à 33434, et incrémentés de 1 à chaque sonde. Les valeurs par défaut sont généralement de 3 sondes par saut (ou incrément TTL), mais elles sont généralement configurables. Lorsque le paquet de la sonde atteint la destination finale, l'hôte renvoie un paquet ICMP Destination inaccessible (en supposant qu'aucune application n'écoute sur ces ports UDP, ce qui n'est pas courant), ce qui indique la fin du Traceroute.
- Traceroute Windows (ou plus précisément tracert.exe) se distingue par l'utilisation de sondes ICMP Echo Request, plutôt que des sondes UDP des implémentations classiques de Traceroute UNIX. Lorsque le paquet de la sonde atteint la destination finale, un paquet ICMP Echo Reply est renvoyé, indiquant la fin du Traceroute.
- "My Traceroute" (MTR) est un autre programme populaire qui peut également utiliser des paquets de sonde ICMP. La différence la plus notable entre MTR et les autres programmes est qu'il effectue ses sondes Traceroute dans une boucle infinie. MTR est extrêmement efficace pour trouver plusieurs chemins parallèles, car il envoie de nombreuses sondes sur une longue période de temps.
Les implémentations modernes de Traceroute permettent à l'utilisateur de spécifier des paquets de sonde UDP, ICMP ou TCP.
Problèmes courants liés à l'analyse Traceroute
Les points suivants expliquent pourquoi une mauvaise interprétation des mesures de Traceroute conduit souvent à un diagnostic erroné, en particulier lors de l'analyse des trois principaux cas d'utilisation : identification du chemin, latence et perte de paquets.
Identification des chemins : Chemins de transfert asymétriques
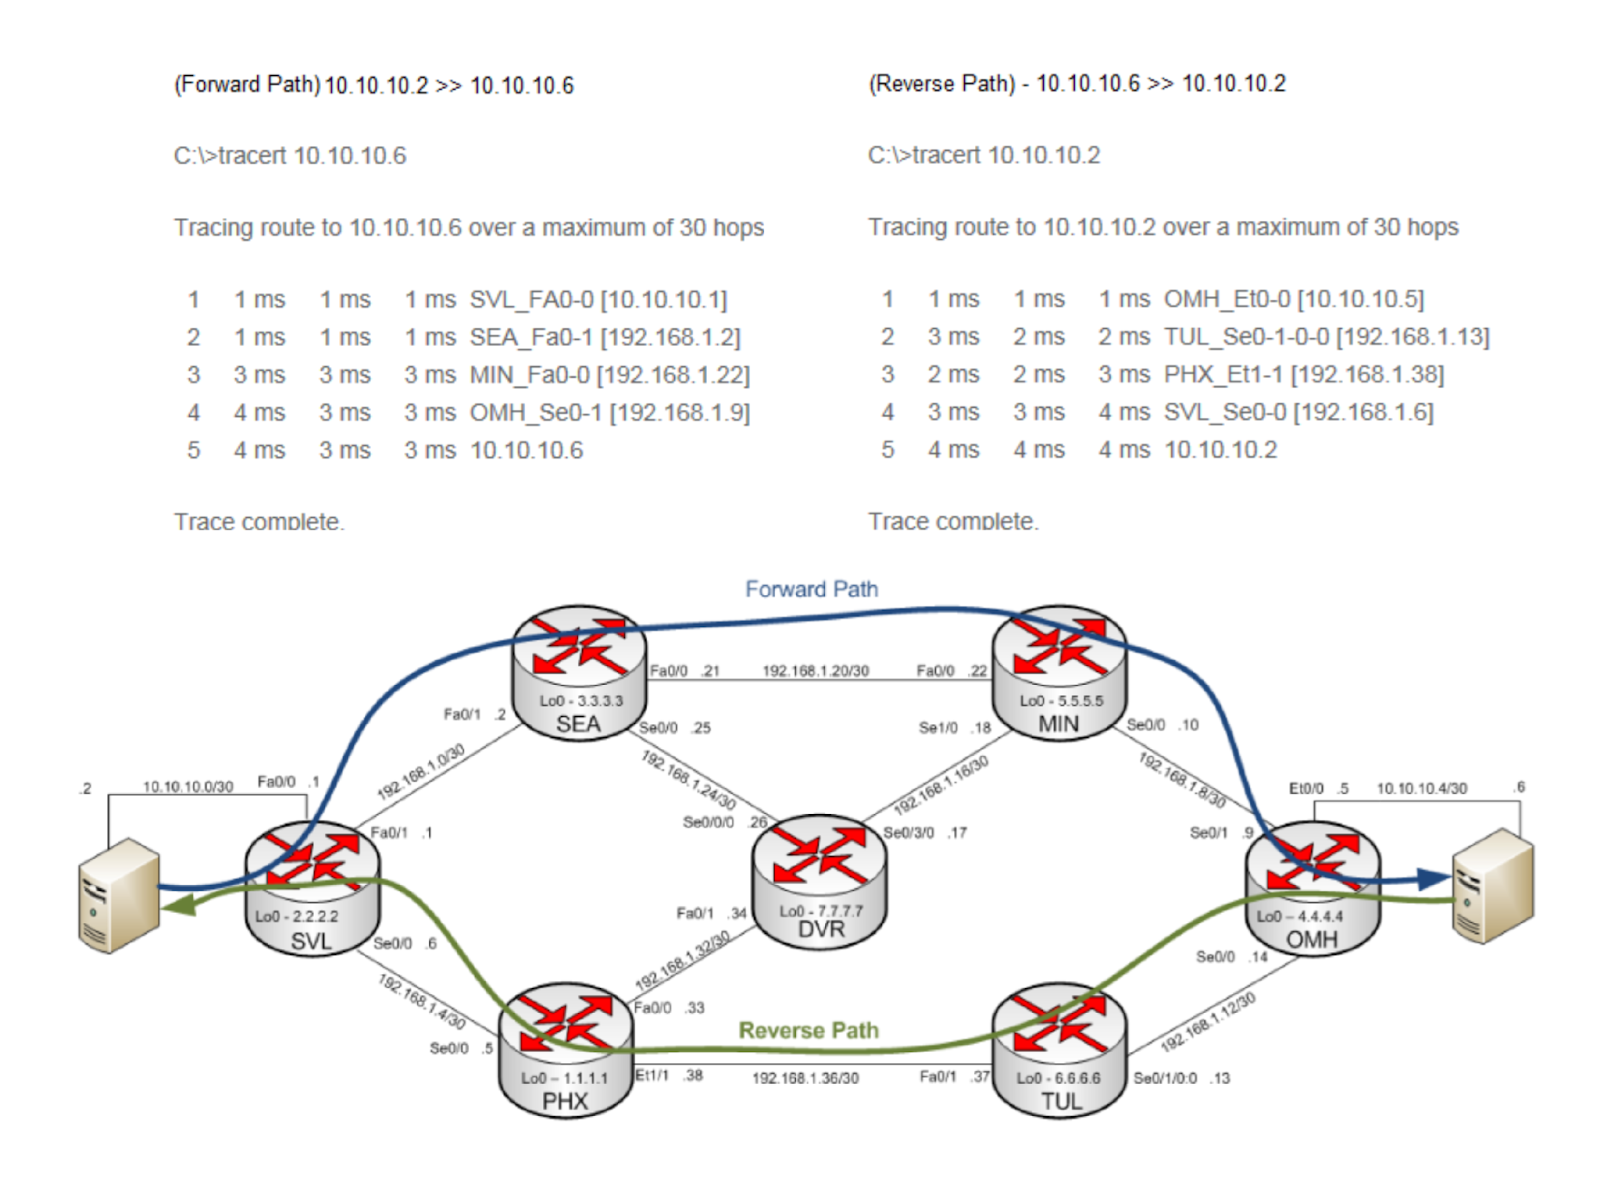
Traceroute ne montre que le chemin d'accès. On croit souvent à tort que le chemin indiqué par traceroute est bidirectionnel. Le chemin inverse est invisible pour Traceroute et peut être complètement différent à chaque saut, et diffère souvent des différents réseaux le long du chemin. Traceroute permet de déterminer si le chemin d'accès à une destination est raisonnable. Pour vérifier le chemin inverse, il est nécessaire d'effectuer un Traceroute distinct de la destination vers l'origine.
Analyse de la latence : Retards dus à la priorisation/limitation du débit de l'ICMP
Les pics de latence sur certains sauts sont souvent causés par la dépriorisation et la limitation du débit de génération des paquets « ICMP TTL Exceed » par le routeur. En revanche, les paquets de données sont transmis beaucoup plus rapidement par des circuits dédiés capables de commuter les paquets à la vitesse de la ligne et qui n'ont pas à solliciter le processeur du routeur lorsqu'il pourrait être occupé à effectuer des tâches plus importantes. Une latence élevée détectée à un saut spécifique n'indique pas automatiquement un impact sur le trafic vers la destination finale. It is crucial to verify whether the increased latency persists in the subsequent hops.
Exemple (Windows) :
>tracert www.amazon.com
Tracing route to cf.47cf2c8c9-frontier.amazon.com [3.164.99.110]
over a maximum of 30 hops:
  1     7 ms     5 ms    6 ms  mynetwork.home [192.168.2.1]
  2    13 ms    39 ms    19 ms  142.124.37.243
  3     *        *        *     Request timed out.
  4     *        *        *     Request timed out.
  5     *        *        *     Request timed out.
  6    12 ms    10 ms    11 ms  142.124.123.156
  7    14 ms    24 ms     9 ms  142.124.125.80
  8    15 ms    36 ms     7 ms  64.230.97.145
  9     *        *        *     Request timed out.
 10     *        *        *     Request timed out.
 11     *        *        *     Request timed out.
 12     *        *        *     Request timed out.
 13     *        *        *     Request timed out.
 14     *        *        *     Request timed out.
 15     9 ms     6 ms    12 ms  server-3-164-99-110.yto53.r.cloudfront.net [3.164.99.110]
Le temps de latence jusqu'à la destination est inférieur au temps de latence signalé dans les sauts précédents. On peut donc ignorer le temps de latence plus élevé aux sauts intermédiaires.
Analyse de la perte de sauts/paquets : Chutes transitoires qui ne persistent pas
Le fait que Traceroute semble s'arrêter ou déposer des paquets au niveau des sauts intermédiaires peut être trompeur. L'abandon d'un paquet à un saut intermédiaire ne signifie pas nécessairement que le trafic vers la destination finale sera également abandonné. Il est important de vérifier les chutes de paquets aux sauts suivants.
La latence ou la perte de paquets constatée lors d'un Traceroute doit être ignorée si les sauts suivants présentent une latence plus faible ou une perte de paquets moindre ou nulle, car chaque paquet qui atteint un saut ultérieur doit être acheminé par le saut précédent. Si la latence ou la perte de paquets apparaît sur un Traceroute et se poursuit jusqu'à la fin, cela peut être le signe d'un problème réel. Ce problème peut se situer sur le chemin aller juste avant le premier saut affecté, ou sur le chemin retour à partir de ce saut et des sauts suivants.
Exemple (Windows) :
>tracert www.google.com
Tracing route to www.google.com [142.250.137.147]
over a maximum of 30 hops:
  1     9 ms     6 ms     4 ms  mynetwork.home [192.168.2.1]
  2     8 ms     9 ms     5 ms  142.124.37.243
  3     *        *        *     Request timed out.  	<------ Hidden hops
  4     *        *        *     Request timed out.
  5     *        *        *     Request timed out.
  6    14 ms    10 ms     8 ms  142.124.123.154
  7     *        9 ms    27 ms  142.124.125.82		<------ Busy routers
  8    13 ms     6 ms     *     64.230.97.147
  9     *        *        *     Request timed out.
 10     *       17 ms    17 ms  192.178.99.39
 11     9 ms    15 ms    11 ms  192.178.99.24
 12    14 ms    24 ms    12 ms  108.170.229.1
 13    10 ms    11 ms    13 ms  142.250.208.188
 14     *        *        *     Request timed out.	<------ Hidden hops
 15     *        *        *     Request timed out.
 16     *        *        *     Request timed out.
 17     *        *        *     Request timed out.
 18     *        *        *     Request timed out.
 19     *        *        *     Request timed out.
 20    15 ms     9 ms    12 ms  pnyyzb-in-f147.1e100.net [142.250.137.147]
Trace complete.
Malgré les nombreuses erreurs "Request timed out", la trace confirme que la connexion à Google est excellente.
- The Destination Was Reached: La dernière ligne (Hop 20) indique que la connexion à Google a été établie avec succès.
- Latency is Excellent: Le temps d'aller-retour jusqu'à la destination est d'environ 12 ms (millisecondes), ce qui est excellent.
- The “Timeouts” (*) Are Normal:
- Hops 3–5: Il s'agit des routeurs internes du FAI. Ils sont configurés pour être "invisibles", mais ils ont laissé passer les paquets suivants avec succès.
- Hops 14–19: Il s'agit du pare-feu de sécurité de Google. Il bloque les outils de suivi traceroute mais permet aux données réelles d'atteindre le serveur final.
Traceroute Metrics
Les principales mesures rapportées par Traceroute qui aident à diagnostiquer les problèmes de réseau sont décrites ci-dessous :
Sauts de routeur (identification de chemin)
Traceroute affiche une liste des sauts de routeur entre une source et une destination. De nombreux facteurs influencent le chemin indiqué par Traceroute.
- Routage asymétrique
Lorsqu'un traceroute est effectué à partir d'une source périphérique vers une destination périphérique, le chemin représenté par les résultats est appelé "forward path". Du point de vue de ce même périphérique source, le chemin du périphérique de destination vers le périphérique source est appelé "chemin inverse". Dans le domaine des réseaux, le fait de connaître le chemin direct ne signifie pas que vous connaissez automatiquement le chemin inverse. Dans certains cas, les chemins peuvent être différents, ce que l'on appelle le "routage asymétrique". Idéalement, ces chemins devraient être identiques ou au moins très similaires. Lorsqu'ils sont très différents, des problèmes de performance peuvent survenir. C'est pourquoi il est très important de confirmer à la fois le chemin aller et le chemin retour, ce qui signifie que les traceroutes doivent être exécutées à partir du périphérique source et du périphérique de destination.
- Équilibrage des charges et chemins multiples
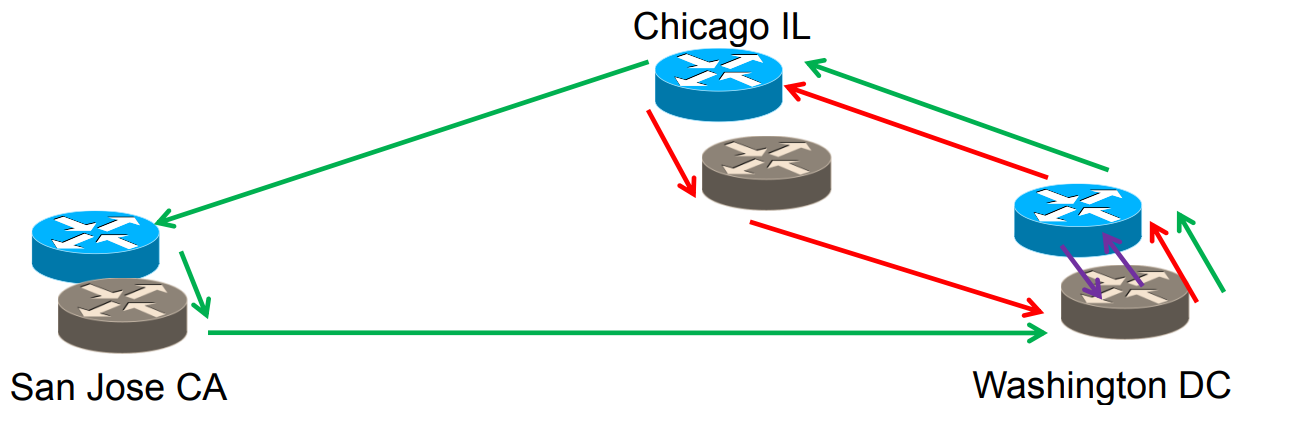
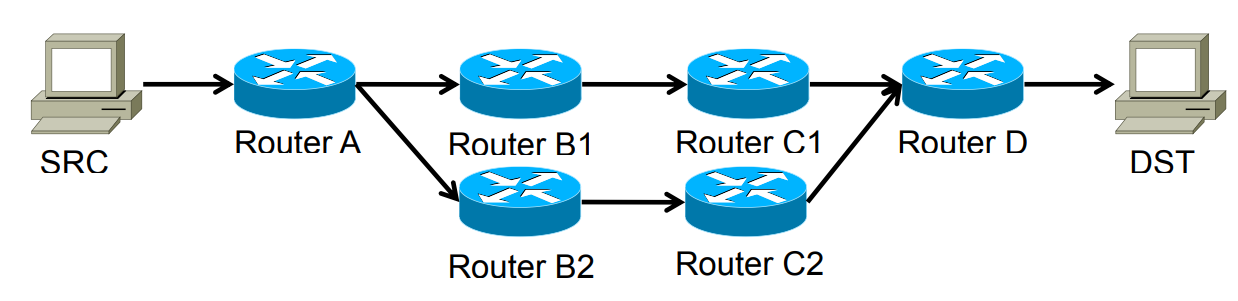
Il peut y avoir des équilibreurs de charge de la couche 3 du réseau (L3) sur le chemin du réseau qui distribuent les paquets à plusieurs routeurs. Dans ce cas, les paquets de sonde peuvent atteindre des routeurs différents qui se trouvent en fait au même "saut" sur le chemin du réseau. Lors de l'évaluation des sauts, il est essentiel de tenir compte de la possibilité que plusieurs chemins d'acheminement, parfois inégaux, soient représentés dans un seul résultat de traceroute.
Example Output:
4 p16-1-0-0.r21.asbnva01.us.bb.gin.ntt.net (129.250.5.21) 0.571 ms 0.604 ms     0.594 ms
5 p16-4-0-0.r00.chcgil06.us.bb.gin.ntt.net (129.250.5.102) 25.981 ms
  p16-1-2-2.r21.nycmny01.us.bb.gin.ntt.net (129.250.4.26) 7.279 ms 7.260 ms
6 p16-2-0-0.r21.sttlwa01.us.bb.gin.ntt.net (129.250.2.180) 71.027 ms
  p16-1-1-3.r20.sttlwa01.us.bb.gin.ntt.net (129.250.2.6) 66.730 ms 66.535 ms
Dans cet exemple, le trafic est réparti sur les deux chemins suivants :
- Ashburn VA - Chicago IL - Seattle WA
- Ashburn VA - New York NY - Seattle WA
MPLS/Tunnels et Traceroute
Lorsque les réseaux utilisent MPLS ou des tunnels pour transporter le trafic IP à travers leur réseau fédérateur, l'encapsulation des paquets employée par ces technologies peut faire en sorte que plusieurs sauts de réseau soient cachés dans les résultats de traceroute, ou même que le même temps de latence soit rapporté sur plusieurs sauts.
Example Output:
1 te2-4.ar5.PAO2.gblx.net (69.22.153.209) 1.160 ms 1.060 ms 1.029 ms
2 192.205.34.245 (192.205.34.245) 3.984 ms 3.810 ms 3.786 ms
3 tbr1.sffca.ip.att.net (12.123.12.25) 74.848 ms 74.859 ms 74.936 ms
4 cr1.sffca.ip.att.net (12.122.19.1) 74.344 ms 74.612 ms 74.072 ms
5 cr1.cgcil.ip.att.net (12.122.4.122) 74.827 ms 75.061 ms 74.640 ms
6 cr2.cgcil.ip.att.net (12.122.2.54) 75.279 ms 74.839 ms 75.238 ms
7 cr1.n54ny.ip.att.net (12.122.1.1) 74.667 ms 74.501 ms 77.266 ms
8 gbr7.n54ny.ip.att.net (12.122.4.133) 74.443 ms 74.357 ms 75.397 ms
9 ar3.n54ny.ip.att.net (12.123.0.77) 74.648 ms 74.369 ms 74.415 ms
10 12.126.0.29 (12.126.0.29) 76.104 ms 76.283 ms 76.174 ms
11 route-server.cbbtier3.att.net (12.0.1.28) 74.360 ms 74.303 ms 74.272 ms
Temps de latence (RTT)
La latence rapportée par Traceroute indique le temps de « trajet aller-retour » pour qu’un paquet arrive au saut et revienne à la source. Pendant le transport, plusieurs facteurs contribuent à la latence.
- Propagation Delay
Temps nécessaire pour que le signal atteigne la destination par le biais du support physique. Pour les réseaux optiques, 100 kilomètres de fibre se traduisent par un délai de propagation d'environ 1ms aller-retour.
- Serialization Delay
Il n'est généralement pas possible de commencer à transmettre le paquet à l'interface de sortie tant que le paquet entier n'a pas été reçu. Pour calculer le délai de sérialisation, il suffit de diviser la taille du paquet par la vitesse de la liaison. Plus la vitesse est élevée, plus le délai de sérialisation est faible.
- Queueing Delay
Lorsqu'une interface est occupée, les paquets à transmettre doivent être mis en file d'attente. Lorsqu'une interface approche du point de saturation, le pourcentage de paquets qui doivent être mis en file d'attente augmente de façon exponentielle et peut ajouter une latence significative.
Les valeurs de latence rapportées par Traceroute sont composées des éléments suivants,
- Le temps nécessaire pour que le paquet de la sonde atteigne un routeur spécifique, plus
- Le temps nécessaire à ce routeur pour générer un paquet ICMP TTL Exceed, plus
- Le temps nécessaire pour que le paquet ICMP retourne à la source de Traceroute.
Les routeurs accordent souvent une faible priorité aux paquets ICMP (chemin lent), traités par l'unité centrale qui pourrait être retardée par d'autres tâches hautement prioritaires gérées par l'unité centrale. Les paquets de données qui passent par le routeur empruntent un chemin rapide qui ne subit pas ces retards. En cas de problème réel, la latence continuera d'augmenter dans les sauts suivants.
Chutes de paquets
Traceroute signale les endroits où il "s'arrête" ou "dépose des paquets". Cela ne signifie pas nécessairement qu'il y a un problème de connexion avec la destination. Les chutes de paquets à un saut sont souvent considérées comme des problèmes de réseau sur le chemin, ce qui n'est généralement pas le cas. Les routeurs peuvent rejeter les paquets de sonde Traceroute pour diverses raisons (limitation du débit, contention du processeur, congestion de l'interface, etc.)
Des chutes de paquets à un saut, suivies de chutes de paquets aux sauts suivants à une fréquence similaire, sont le signe d'un problème. Toutefois, si des paquets sont abandonnés à un saut mais qu'il n'y a pas d'abandon dans les sauts suivants, ce n'est souvent pas un problème.
Reverse DNS
Les outils de traçage peuvent effectuer une recherche DNS inversée pour les IP des routeurs et indiquer les noms. Ces valeurs peuvent ne pas suivre un format standard, mais elles aident grandement à comprendre les différents aspects du chemin du réseau, ce qui peut faciliter le dépannage.
- Identifiants de lieu - codes d'aéroport IATA, codes CLLI, valeurs arbitraires.
- Types de routeurs / rôles - routeur principal, routeur de périphérie, etc.
- Limites du réseau - les limites du réseau sont des points de transfert où les politiques administratives changent et où la capacité est la plus limitée, ce qui conduit souvent à des voies de retour modifiées ou à des encombrements.
- Types d'interface - 10 Gigabit Ethernet, Gigabit Ethernet, ATM, etc.
Prenons l'exemple de xe-11-1-0.edge1.NewYork1.Level3.net. Le schéma de dénomination xe-#-#-# est une interface Juniper 10GE : FPC 11, PIC 1, port 0. La présence de FPC 11 indique au moins un châssis à 12 emplacements.
Il est parfois facile de détecter les limites d'un réseau à partir des noms DNS :
4 te1-2-10g.ar3.DCA3.gblx.net (67.17.108.146)
5 sl-st21-ash-8-0-0.sprintlink.net (144.232.18.65)
Dépasser Traceroute : Digital Experience Management
Alors que Traceroute fournit des informations fondamentales sur le chemin du réseau, la plupart des utilisateurs ont souvent besoin d'informations plus approfondies, de moins de risques d'erreurs d'interprétation et d'une approche proactive de la gestion de l'expérience de l'utilisateur. NetskopeLe site Digital Experience Management (DEM) est conçu pour répondre aux limites inhérentes à Traceroute en intégrant des mesures de performance approfondies dans la plate-forme. DEM vous offre une visibilité contextuelle de chaque étape du flux de trafic. Cela permet d'obtenir une vue plus précise et plus exploitable des performances du réseau.
1. Path Identification: Asymmetric Forwarding Paths
La principale limite à l'identification du chemin est que Traceroute ne montre que le chemin aller : le chemin retour et le flux de bout en bout sont invisibles. Ce manque de visibilité introduit une grande ambiguïté quant à l'itinéraire réel et à l'origine des retards éventuels.
Pour lever cette ambiguïté et approfondir l'identification des chemins, DEM offre une visibilité complète du périphérique à l'application. DEM contrôle l'expérience réelle de l'utilisateur et la performance de chaque étape, du périphérique à l'application. Cette visibilité multicouche mesure avec précision l'ensemble du chemin emprunté par le trafic des utilisateurs, ce qui permet de comprendre l'ensemble du flux aller-retour. Pour en savoir plus, veuillez consulter la rubrique Présentation de l'utilisateur.
2. Latency Analysis: Delays from ICMP Prioritization/Rate Limiting
Une erreur de diagnostic fréquente se produit car les pics de latence sont souvent de faux positifs causés par le routeur qui dé-priorise et limite le débit de la réponse ICMP TTL Exceed. Cela signifie que les données reflètent la charge du processeur du routeur, et non la capacité de transmission du réseau.
Pour obtenir des précisions sur la latence réelle du réseau et des applications, Netskope DEM utilise le contrôle de l'activité des utilisateurs réels. DEM mesure les performances en se basant sur le suivi de l'activité des utilisateurs réels et sur l'analyse du trafic, et non sur la réponse du plan de contrôle. En suivant les mesures de performance du trafic réel, DEM rend compte de la performance réelle des applications et du réseau.
3. Hop/Packet Loss Analysis: Spikes and Drops That Do Not Persist
Il est difficile de diagnostiquer une perte de paquets ou une latence élevée à l'aide de Traceroute, car de faux rapports se produisent lorsque des pics ou des chutes temporaires ne persistent pas, ce qui rend difficile la distinction entre les problèmes réels et le bruit du réseau.
Afin de clarifier définitivement l'impact et la portée des déficiences, DEM utilise des alertes pour diagnostiquer, prédire et hiérarchiser les événements, en réduisant efficacement les faux positifs. Les mesures fournissent des données précieuses sur l'expérience de l'utilisateur, y compris la santé du périphérique, le réseau et la performance de l'application, ce qui clarifie immédiatement l'étendue et l'impact de toute déficience. Ces données contextuelles permettent un diagnostic complet de tout problème potentiel de perte de paquets ou de latence.